精心编写的
robots.txt能节省服务器资源、保护原创内容并将爬取预算集中在最有价值的页面上。本指南提供创建、测试与更新robots.txt的实用步骤与示例,帮助你掌控爬虫行为并提升技术 SEO 表现。
January 11, 2026 (9mo ago) — last updated August 13, 2026 (2mo ago)
快速生成 robots.txt:技术 SEO 指南
分步教你生成与测试 robots.txt,优化爬取预算、保护内容并应对 AI 爬虫,包含示例与最佳实践。
← Back to blog
Generate robots.txt: 快速 SEO 指南
摘要: 学习如何创建并部署 robots.txt 文件以控制爬虫、保护内容并通过实用示例优化爬取预算。
介绍
精心编写的 robots.txt 文件让你掌控哪些爬虫可以访问你的网站,帮助保护有价值的内容,并将爬取预算集中在重要页面上。本指南展示了创建、测试和更新 robots.txt 的清晰实用步骤,以便搜索引擎和守规则的机器人按你希望的方式行为。
开始之前
创建一个名为 robots.txt 的纯文本文件,添加像 User-agent: 和 Disallow: 这样的指令,并将其上传到你网站的根目录:https://yourdomain.com/robots.txt。这单个文件就是给搜索引擎爬虫和其他机器人发出的简单指令集。
为什么你的 robots.txt 文件是关键的 SEO 工具
搞错 robots.txt 看起来可能很技术,但它是你网站的守门人。正确使用时,它能节省服务器资源并将爬虫引导到高价值页面,从而改善索引和排名。Robots 排除协议的角色已经随着网络演变成为站点基础设施的重要组成部分1。
一个有针对性的 robots.txt 能帮助你把爬虫引导到带来流量、潜在客户和收入的页面,同时让它们远离浪费爬取预算的区域,例如管理页面、站内搜索结果和重复的打印友好页面。
“robots.txt 文件不仅仅是一个排除列表;它是给搜索引擎的战略指南。它告诉它们在你的网站上应该把有限的时间花在哪里,从而直接影响哪些页面被索引和排名。”
归根结底,正确设置 robots.txt 意味着更好的 SEO 表现、保存服务器资源,以及让最有价值的内容更易被发现。
理解爬虫的语言
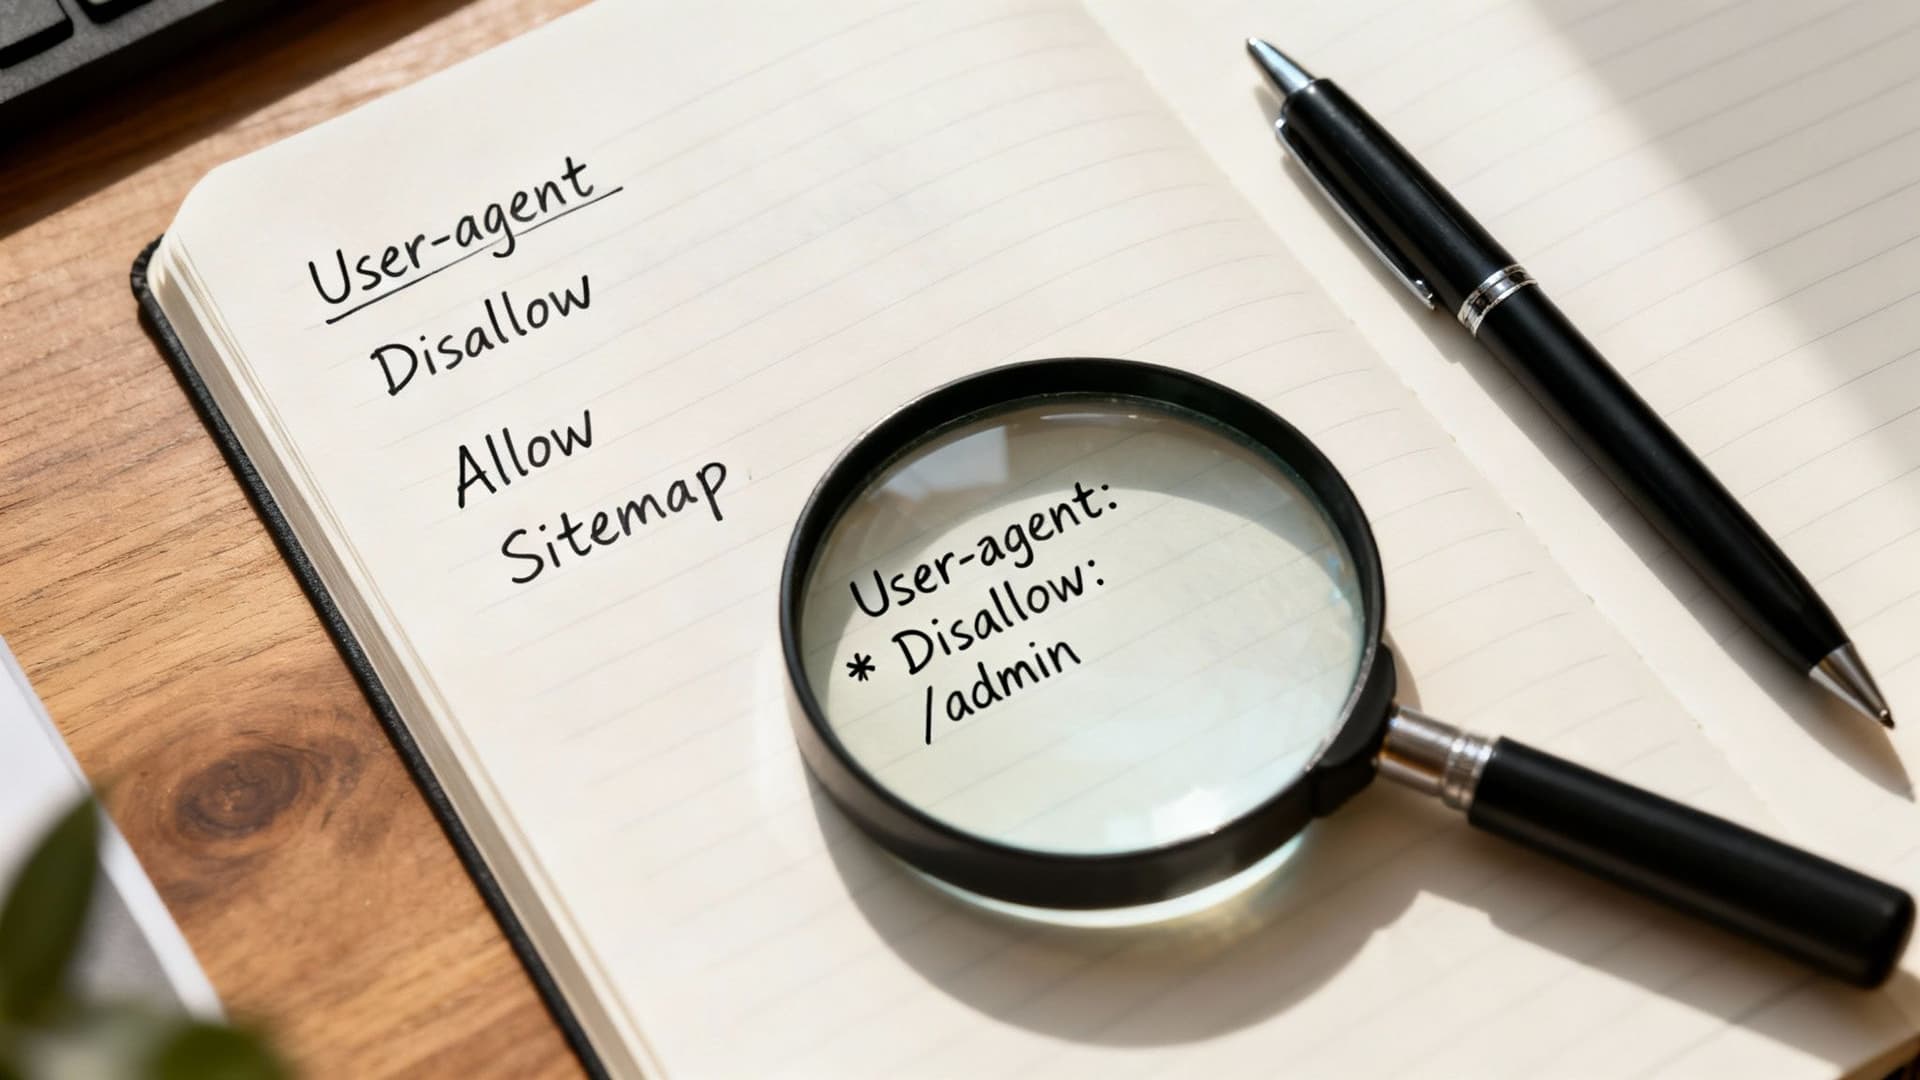
robots.txt 是与爬虫的一段简短对话。该文件使用简单的指令来指示哪些门是开着的,哪些是关着的。这些命令直接且构成健康技术性 SEO 策略的基础。
核心 robots.txt 指令说明
| 指令 | 它的作用 | 何时使用 |
|---|---|---|
| User-agent | 指定哪些爬虫适用这些规则。* 是对所有机器人通配符。 | 使用 User-agent: * 来设置通用规则,或指定 Googlebot 或 Bingbot 以发送针对性的指令。 |
| Disallow | 告诉机器人不要抓取特定文件或目录。 | 阻止管理登录页面(/wp-admin/)、站内搜索结果或无用的感谢页面。 |
| Allow | 为特定子文件夹或文件覆盖 Disallow。 | 在被禁止的目录内允许单个文件被抓取。 |
| Sitemap | 指向你的 sitemap XML 文件,便于爬虫发现重要页面。 | 始终包含此项以加速你希望被收录页面的发现。 |
这些简单的命令让你对爬虫行为拥有强有力的控制。掌握它们有助于你创建有效的 robots.txt 文件。
将指令付诸实践
如果你有一个重要的交互工具——比如一个用于获取潜在客户的计算器——你会希望搜索引擎抓取并索引它。与此同时,你会想要阻止那些没有 SEO 价值的页面。一个常见且实用的 robots.txt 如下:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
这个配置使用 User-agent: * 来针对所有机器人,阻止一些常见的非公开文件夹,并指向网站地图。它干净且高效。
要了解爬虫的行为,分析服务器日志和访问者数据。一旦你知道哪些机器人在访问你的网站,就可以制定支持业务目标的规则。分析日志是判断是否需要屏蔽特定爬虫的重要步骤2。
手动创建 robots.txt 文件的实用指南
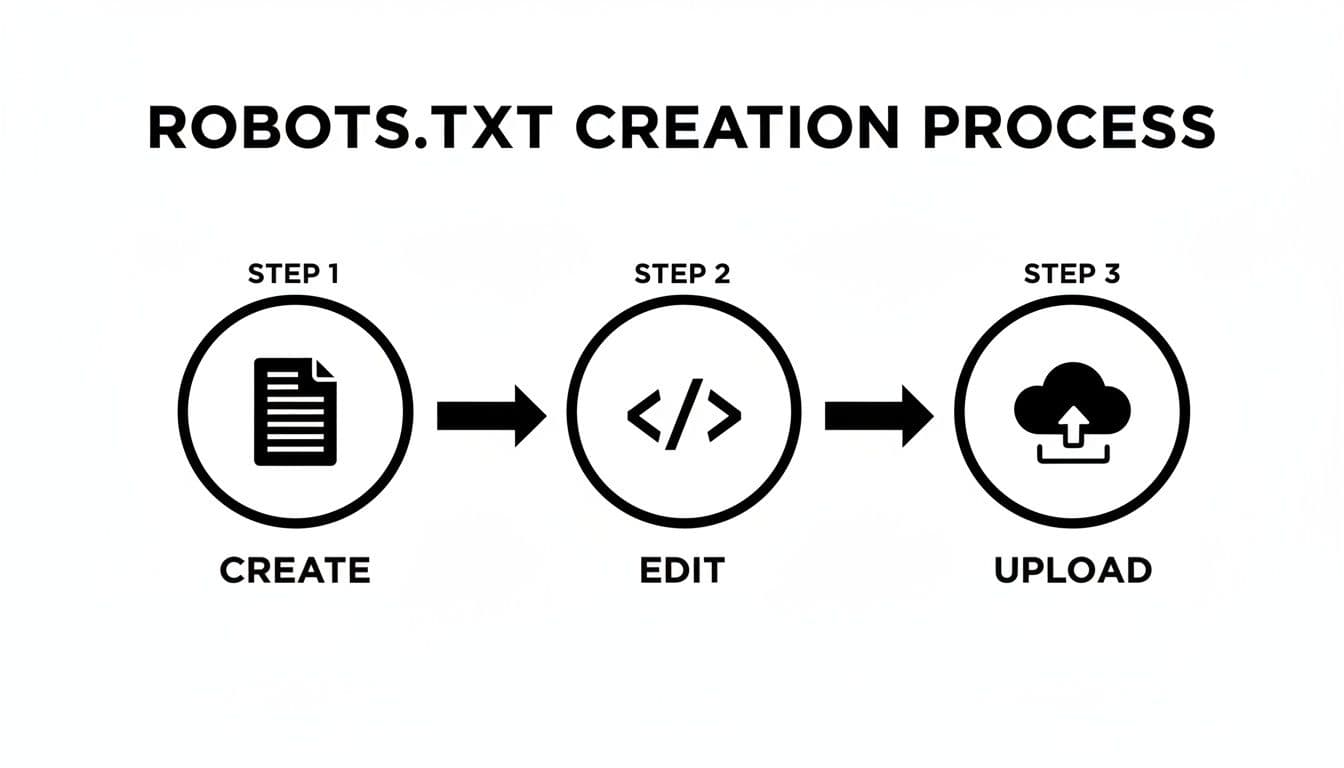
有时候你需要手工创建文件。使用 Notepad 或 TextEdit,将文件保存为名为 robots.txt(小写)的纯文本,然后通过 FTP 或主机的文件管理器上传到站点根目录。如果你以 .docx 或 .rtf 格式保存,爬虫将忽略它。
将它放在 https://yourdomain.com/robots.txt。如果你把它上传到子文件夹,比如 /blog/robots.txt,爬虫将无法看到它。
为现实业务目标制定规则
示例:一个有潜在客户获取功能的金融服务网站,带有一个按揭计算器。你希望该工具被索引,但不希望管理区域或感谢页面出现在搜索结果中。可以这样设置规则:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
这告诉所有爬虫它们可以抓取站点,除了 /admin/ 和感谢页面,并指向站点地图。像这样包含一行 sitemap 可以帮助爬虫更快地找到深层或重要页面。
注意:在更复杂的文件中,顺序很重要。对于重叠的
Allow和Disallow规则,最具体的规则应该放在前面以适用于 Googlebot,否则你可能会无意中阻止内容。
创建并测试你的 robots.txt 是任何技术性 SEO 审计中的核心步骤。
管理新一波的 AI 与大语言模型爬虫
爬虫生态现在包括专门的 AI 机器人,例如 GPTBot 和 Common Crawl。这些爬虫增长迅速,许多站点正在调整规则以应对它们。守规则的 AI 爬虫会遵守 robots.txt,但恶意的抓取器可能不会4。
为什么你可能会屏蔽 AI 爬虫
屏蔽 AI 爬虫可以保护原创内容不被抓取并在未经归属或补偿的情况下用于模型训练。如果你构建了独特的在线工具,你可能不希望其逻辑或数据被第三方收集利用。在 AI 驱动平台上的可见性带来的好处,需要与你的内容被重用的风险权衡。
分析日志文件可以帮助你查看哪些机器人访问你的网站,并决定是否屏蔽它们2。
如何屏蔽常见的 AI 机器人
为你想屏蔽的每个爬虫添加特定的 User-agent 行。示例包括 GPTBot、CCBot、Google-Extended 和 Anthropic-AI。要完全屏蔽某个机器人:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
记住,robots.txt 是一种荣誉系统。知名爬虫会遵守你的规则,但恶意行为者可能会无视它们。为了更强的保护,考虑使用 Web 应用防火墙(WAF)或专门的机器人管理解决方案。
避免常见且代价高昂的 robots.txt 错误
一个错位的行可能会意外将你整个站点从索引中移除。经典错误是 Disallow: /,它会告诉所有爬虫不要抓取任何页面。如果你的网站突然从搜索结果中消失,首先检查 robots.txt。
阻止关键文件
阻止 CSS 或 JavaScript 会妨碍 Google 正确渲染页面,这会伤害 SEO。例如,如果你的网站依赖 JavaScript 来加载重要内容,不要阻止 /assets/js/。当需要时,应该使用 Allow: 来允许这些资源:
- 之前(错误):
Disallow: /assets/js/ - 之后(正确):
Allow: /assets/js/
冲突规则和语法错误
规则从上到下读取,更具体的规则应放在更广泛规则之前。如果你想阻止 /private/ 文件夹但允许其中的单个 PDF,请将 Allow 规则先放以适用于 Googlebot:
Allow: /private/public-report.pdf
Disallow: /private/
还要注意拼写错误。像 “dissallow” 这样的拼写错误会被忽略。部署更改前使用 Google Search Console 的 robots.txt 测试工具来验证预期行为5。
记住,robots.txt 是一种礼貌请求,而非保证。许多大型出版商正在屏蔽 AI 训练机器人,但有决心的抓取者可以完全无视你的文件4。
关于 robots.txt 文件的常见问题
Robots.txt 与 noindex:有什么区别?
Robots.txt 阻止抓取,而 noindex 标签阻止索引。使用 robots.txt 来阻止爬虫访问管理页面等部分;对于你希望被抓取但不希望出现在搜索结果中的页面(例如临时着陆页),使用 noindex。
我应该把 sitemap 添加到 robots.txt 吗?
应该。添加 Sitemap: https://www.yourdomain.com/sitemap.xml 有助于爬虫更快地发现并索引深层链接的高价值内容。如果你使用多个站点地图,为每个文件添加一行 Sitemap:。
robots.txt 能阻止坏机器人和抓取器吗?
robots.txt 有帮助但并非万无一失。它对守规则的爬虫有效,但恶意抓取器通常会忽略它。为了强有力的防护,将 robots.txt 与服务器级别的控制、WAF 和机器人管理工具结合使用。
准备通过交互式工具提升你的网站参与度和 SEO 吗?使用 MicroEstimates,你可以在网站上构建并嵌入自定义计算器。试试这些工具以支持潜在客户获取和用户参与:
快速问答 — 常见读者问题
对大多数网站来说最简单的 robots.txt 是什么?
从以下开始:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
我如何屏蔽 GPTBot 或其他 AI 爬虫?
为每个爬虫添加一个 User-agent 指令,并在其下添加 Disallow: /。
我如何在部署前测试我的 robots.txt?
使用 Google Search Console 的 robots.txt 测试工具,并检查服务器日志以确认期望的行为5。
三个简洁问答(底部)
robots.txt 会影响我的索引速度吗?
会。正确的 Sitemap 声明和有针对性的 Allow/Disallow 规则能让爬虫更快地发现重要页面,从而改善索引效率3。
我应否屏蔽所有 AI 爬虫?
不一定。屏蔽能保护原创材料不被训练模型采集,但也可能阻断带来流量的守规则爬虫。通过日志分析判断哪些爬虫有价值,再决定是否屏蔽2。
部署后如何监控 robots.txt 的效果?
定期查看服务器日志、Search Console 报告和页面索引状态。遇到索引异常时,优先检查 robots.txt 是否误阻了关键资源5。
1.
Robots Exclusion Protocol 的起源和历史。 https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
关于如何通过日志分析判断爬虫流量与管理 AI 爬虫的建议。 https://developers.google.com/search/docs/advanced/robots/intro
3.
将 sitemap 添加到 robots.txt 有助于爬虫发现重要页面的说明。 https://developers.google.com/search/docs/advanced/sitemaps/overview
4.
5.
使用 Google Search Console 的 robots.txt 测试工具和调试方法。 https://support.google.com/webmasters/answer/6062598
准备构建您自己的工具了吗?
加入数百家已经使用自定义估算工具来增加利润和赢得更多客户的企业
✨ 无需编程 • 🚀 几分钟即可完成 • 💸 免费创建