Узнайте, как сгенерировать файл robots.txt, чтобы контролировать краулеров и улучшить техническое SEO с помощью практического пошагового руководства.
January 11, 2026 (9mo ago)
Освойте SEO: создайте файл robots.txt с этим быстрым руководством
Узнайте, как сгенерировать файл robots.txt, чтобы контролировать краулеров и улучшить техническое SEO с помощью практического пошагового руководства.
← Back to blog
Генерация robots.txt: Быстрое руководство по SEO
Кратко: Научитесь создавать и развёртывать файл robots.txt, чтобы контролировать краулеров, защищать контент и оптимизировать бюджет обхода с практическими примерами.
Введение
Хорошо составленный файл robots.txt даёт вам контроль над тем, какие краулеры могут получать доступ к вашему сайту, помогает защитить ценный контент и фокусирует бюджет обхода на страницах, которые действительно важны. Это руководство показывает чёткие, практические шаги по созданию, тестированию и обновлению robots.txt, чтобы поисковые системы и вежливые боты вели себя так, как вам нужно.
С чего начать
Создайте текстовый файл с именем robots.txt, добавьте директивы вроде User-agent: и Disallow:, и загрузите его в корень сайта по адресу https://yourdomain.com/robots.txt. Один файл служит простым набором инструкций для краулеров поисковых систем и других ботов.
Почему файл robots.txt — критический инструмент SEO
Работа с robots.txt может показаться технической задачей, но это вратарь вашего сайта. При корректном использовании он сохраняет ресурсы сервера и направляет краулеров к страницам с высокой ценностью — улучшая индексирование и позиции в выдаче. Протокол исключения роботов (Robots Exclusion Protocol) зародился в ранней сети и со временем превратился в ключевой элемент инфраструктуры сайта.1
Фокусированный robots.txt помогает направлять краулеров на страницы, которые приносят трафик, лиды и выручку, одновременно удерживая их подальше от зон, где тратится бюджет обхода, таких как страницы администратора, результаты внутреннего поиска и дублирующие печатные версии страниц.
Файл robots.txt — это больше, чем список исключений; это стратегическое руководство для поисковых систем. Он говорит им, куда потратить своё ограниченное время на вашем сайте, напрямую влияя на то, какие страницы будут проиндексированы и ранжированы.
В конечном счёте правильная настройка robots.txt означает лучшую SEO-эффективность, сохранённые ресурсы сервера и более чёткое обнаружение вашего самого ценного контента.
Понимание языка веб-краулеров
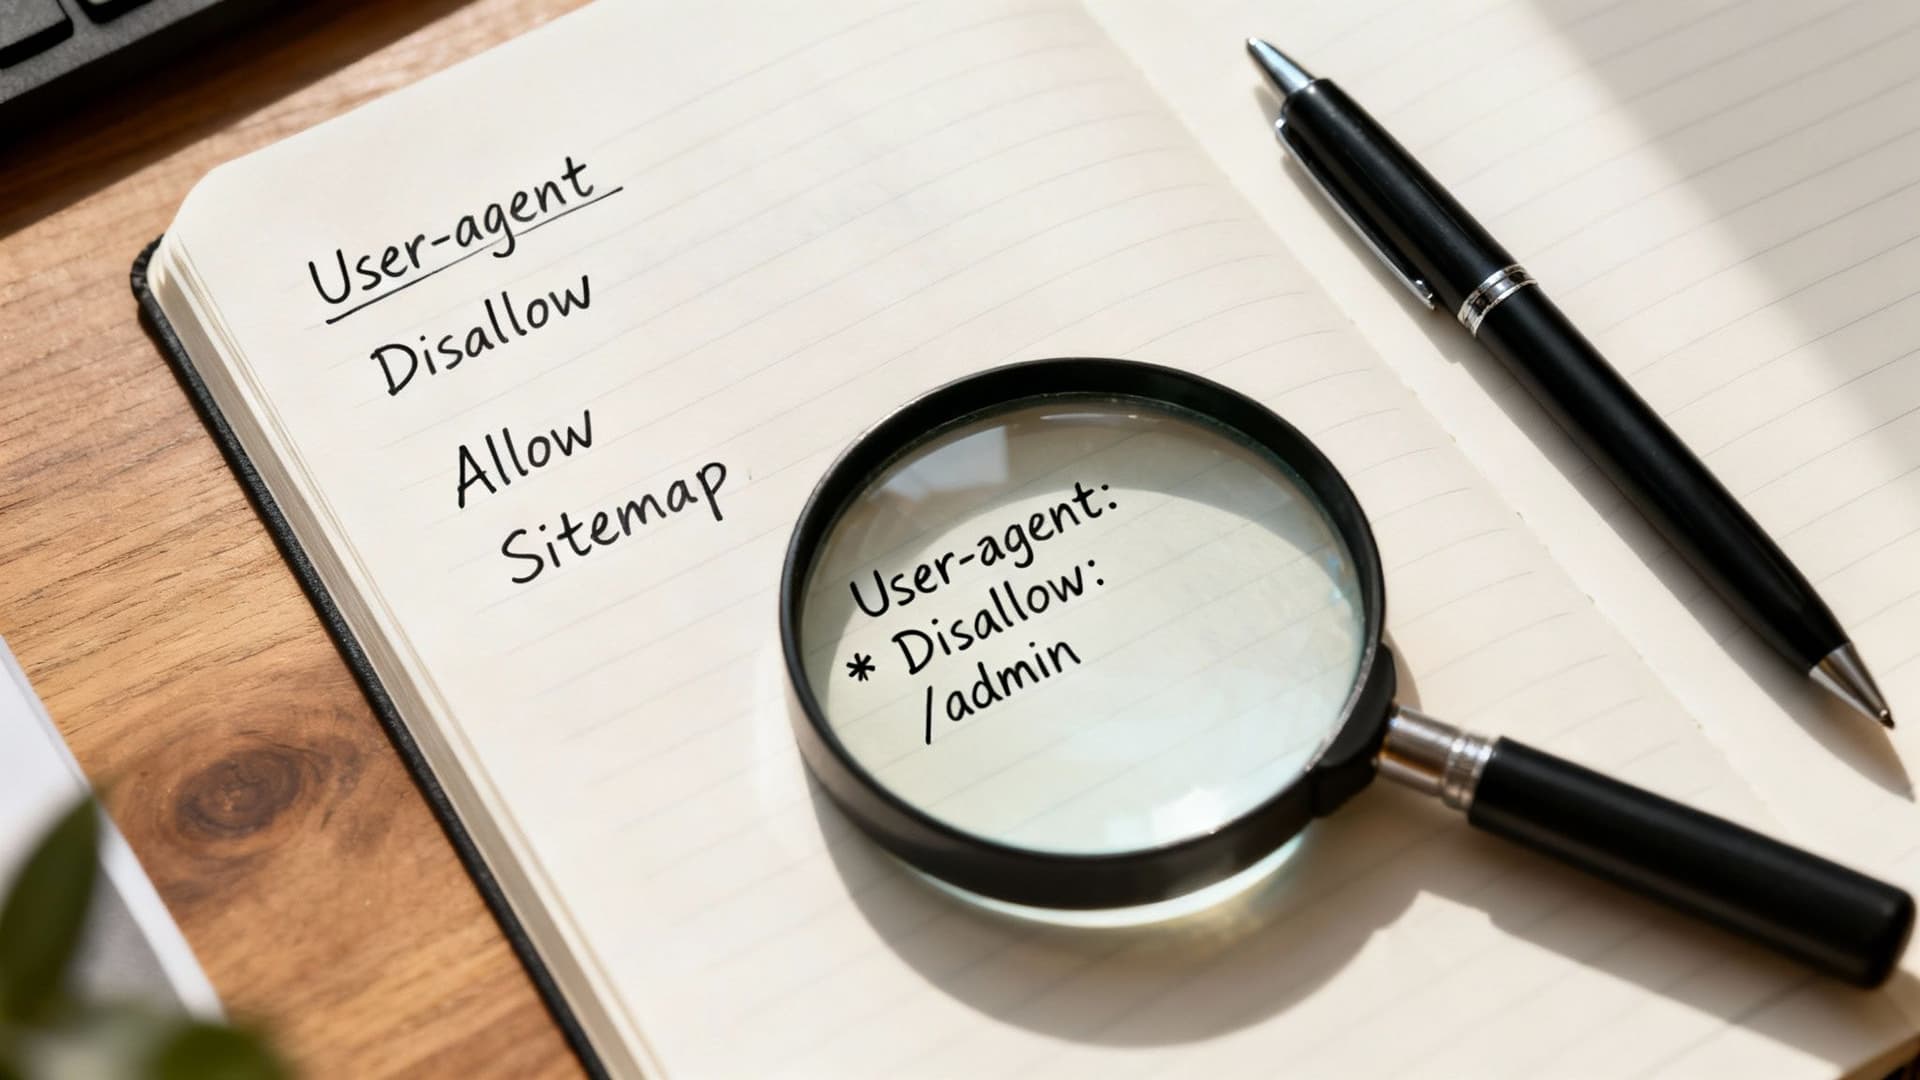
Robots.txt — это короткий разговор с краулерами. Файл использует простые директивы, чтобы указать, какие двери открыты, а какие закрыты. Эти команды просты и составляют основу здоровой технической SEO-стратегии.
Объяснение основных директив robots.txt
| Directive | What it does | When to use it |
|---|---|---|
| User-agent | Specifies which crawler the rules apply to. * is a wildcard for all bots. | Use User-agent: * for general rules, or specify Googlebot or Bingbot for targeted instructions. |
| Disallow | Tells bots not to crawl a specific file or directory. | Block admin login pages (/wp-admin/), internal search results, or unhelpful thank-you pages. |
| Allow | Overrides a Disallow for a specific subfolder or file. | Allow a single file inside a disallowed directory. |
| Sitemap | Points crawlers to your sitemap XML file so they can discover important pages. | Always include this to speed discovery of pages you want indexed. |
Эти простые команды дают вам сильный контроль над поведением краулеров. Освоение их помогает создать эффективный robots.txt.
Применение директив на практике
Если у вас есть важный интерактивный инструмент — например, калькулятор для генерации лидов — вы хотите, чтобы поисковые системы его обходили и индексировали. В то же время вы захотите блокировать страницы, которые не приносят SEO-ценности. Типичный практичный robots.txt выглядит так:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
Эта конфигурация использует User-agent: * для всех ботов, блокирует несколько общих непубличных папок и указывает краулерам на карту сайта. Это чисто и эффективно.
Чтобы узнать больше о поведении краулеров, анализируйте журналы сервера и данные о посетителях. Как только вы поймёте, какие боты посещают ваш сайт, вы сможете создавать правила, поддерживающие цели вашего бизнеса.
Практическое руководство по созданию robots.txt вручную
Иногда файл лучше создать вручную. Используйте Notepad или TextEdit, сохраните файл как обычный текст под именем robots.txt (в нижнем регистре) и загрузите его в корень сайта через FTP или файловый менеджер хоста. Если вы сохраните его как .docx или .rtf, краулеры проигнорируют файл.
Разместите его по адресу https://yourdomain.com/robots.txt. Загрузка в подпапку, например /blog/robots.txt, сделает его невидимым для краулеров.
Создание правил под реальные бизнес-цели
Пример: сайт финансовых услуг с калькулятором ипотеки для генерации лидов. Вы хотите, чтобы этот инструмент индексировался, но не хотите видеть в результатах админ-панели или страницы благодарности. Установите правила так:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
Это указывает всем краулерам, что они могут обходить сайт, за исключением /admin/ и страницы благодарности, и направляет их к карте сайта. Включите строку Sitemap для помощи краулерам в более быстром обнаружении глубоко вложенных или важных страниц.
Примечание: порядок имеет значение в более сложных файлах. Для перекрывающихся правил
AllowиDisallowсамое специфичное правило должно идти первым для Googlebot, иначе вы рискуете нечаянно заблокировать контент.
Создание и тестирование robots.txt — ключевой этап любого технического SEO-аудита.
Управление новой волной краулеров ИИ и LLM
Ландшафт краулеров теперь включает боты, специфичные для ИИ, такие как GPTBot и Common Crawl. Эти краулеры быстро выросли, и многие сайты корректируют правила, чтобы учитывать их. Вежливые краулеры ИИ будут соблюдать robots.txt, но злонамеренные скрейперы могут это игнорировать.2
Почему вы можете блокировать краулеров ИИ
Блокировка краулеров ИИ может защитить оригинальный контент от скрейпинга и использования для обучения моделей без указания источника или компенсации. Если вы создали уникальный онлайн-инструмент, вы можете не хотеть, чтобы его логику или данные собирали третьи стороны. Взвесьте преимущества видимости на платформах с ИИ против риска повторного использования вашего контента.
Анализ логов помогает увидеть, какие боты посещают ваш сайт и решать, стоит ли их блокировать.3
Как блокировать распространённых ботов ИИ
Добавьте конкретные строки User-agent для каждого краулера, которого хотите заблокировать. Примеры: GPTBot, CCBot, Google-Extended и Anthropic-AI. Чтобы полностью заблокировать бота:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Помните, robots.txt — это система чести. Авторитетные краулеры будут уважать ваши правила, но злонамеренные акторы могут их игнорировать. Для более надёжной защиты рассмотрите использование веб-аппликационного файрвола (WAF) или специализированного решения для управления ботами.
Избегание распространённых и дорогостоящих ошибок в robots.txt
Одна неправильно поставленная строка может случайно вывести весь ваш сайт из индекса. Классическая ошибка — Disallow: /, которая говорит всем краулерам не обходить никакие страницы. Если ваш сайт внезапно исчез из результатов поиска, сначала проверьте robots.txt.
Блокировка необходимых файлов
Блокировка CSS или JavaScript может помешать Google корректно отрисовывать страницы, что вредно для SEO. Например, не блокируйте /assets/js/, если ваш сайт полагается на JavaScript для загрузки важного контента. Вместо этого используйте Allow: для этих ресурсов, когда это необходимо:
- Раньше (неправильно):
Disallow: /assets/js/ - Теперь (правильно):
Allow: /assets/js/
Конфликтующие правила и синтаксические ошибки
Правила читаются сверху вниз, и более конкретные правила должны идти перед более общими. Если вы хотите блокировать папку /private/, но разрешить один PDF внутри неё, поместите правило Allow первым для Googlebot:
Allow: /private/public-report.pdf
Disallow: /private/
Также следите за опечатками. Неправильно написанная директива, например "dissallow", игнорируется. Используйте тестировщик robots.txt в Google Search Console перед развёртыванием изменений.
Помните, robots.txt — вежливая просьба, а не гарантия. Многие крупные издатели блокируют ботов, обучающих ИИ, но настойчивые скрейперы могут полностью игнорировать ваш файл.4
Частые вопросы о файлах robots.txt
Robots.txt против noindex: в чём разница?
Robots.txt останавливает обход, тогда как тег noindex останавливает индексирование. Используйте robots.txt, чтобы предотвратить посещение разделов вроде админ-страниц; используйте noindex на страницах, которые вы хотите, чтобы обходили, но не показывали в результатах поиска, например временные посадочные страницы.
Стоит ли добавлять sitemap в robots.txt?
Да. Добавление Sitemap: https://www.yourdomain.com/sitemap.xml помогает краулерам быстрее обнаруживать и индексировать глубоко вложенный, ценный контент. Если у вас несколько карт сайта, добавьте по одной строке Sitemap: на файл.
Может ли robots.txt остановить плохих ботов и скрейперов?
Robots.txt помогает, но не является панацеей. Он эффективен против вежливых краулеров, но злонамеренные скрейперы часто его игнорируют. Для надёжной защиты сочетайте robots.txt с контролями на уровне сервера, WAF и инструментами управления ботами.
Готовы повысить вовлечённость и SEO вашего сайта с помощью интерактивных инструментов? С MicroEstimates вы можете создавать и внедрять кастомные калькуляторы на сайт. Попробуйте эти инструменты для генерации лидов и увеличения вовлечённости пользователей:
Быстрый Q&A — распространённые вопросы читателей
Какой самый простой robots.txt для большинства сайтов?
Начните с:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
Как заблокировать GPTBot или других краулеров ИИ?
Добавьте директиву User-agent для каждого краулера и установите Disallow: / под ней.
Как протестировать robots.txt перед развёртыванием?
Используйте тестировщик robots.txt в Google Search Console и проверьте журналы сервера, чтобы подтвердить ожидаемое поведение.
1.
Происхождение и история протокола исключения роботов. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Отчёты об автоматическом бот-трафике и его доле в веб-трафике. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Анализ и рекомендации по управлению краулерами ИИ и анализу логов. https://developers.google.com/search/docs/advanced/robots/intro
4.
Материалы о том, как издатели блокируют ботов для обучения ИИ. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
Готовы создать свои собственные инструменты бесплатно?
Присоединитесь к сотням предприятий, которые уже используют пользовательские инструменты оценки для увеличения прибыли и привлечения большего числа клиентов
✨ Кодирование не требуется • 🚀 Готов за минуты • 💸 Бесплатно создать