Aprenda a gerar um ficheiro robots.txt para controlar rastreadores e potenciar o SEO técnico com um guia prático e mão na massa.
January 11, 2026 (9mo ago)
Domine o SEO: gere um ficheiro robots.txt com este guia rápido
Aprenda a gerar um ficheiro robots.txt para controlar rastreadores e potenciar o SEO técnico com um guia prático e mão na massa.
← Back to blog
Gerar robots.txt: Guia Rápido de SEO
Resumo: Aprenda a criar e a implantar um ficheiro robots.txt para controlar rastreadores, proteger conteúdo e otimizar o orçamento de rastreamento com exemplos práticos.
Introdução
Um ficheiro robots.txt bem elaborado dá-lhe controlo sobre que rastreadores podem aceder ao seu site, ajuda a proteger conteúdo valioso e foca o orçamento de rastreamento nas páginas que importam. Este guia mostra passos claros e práticos para criar, testar e atualizar o seu robots.txt, de modo a que motores de busca e bots educados se comportem da forma que pretende.
Para começar
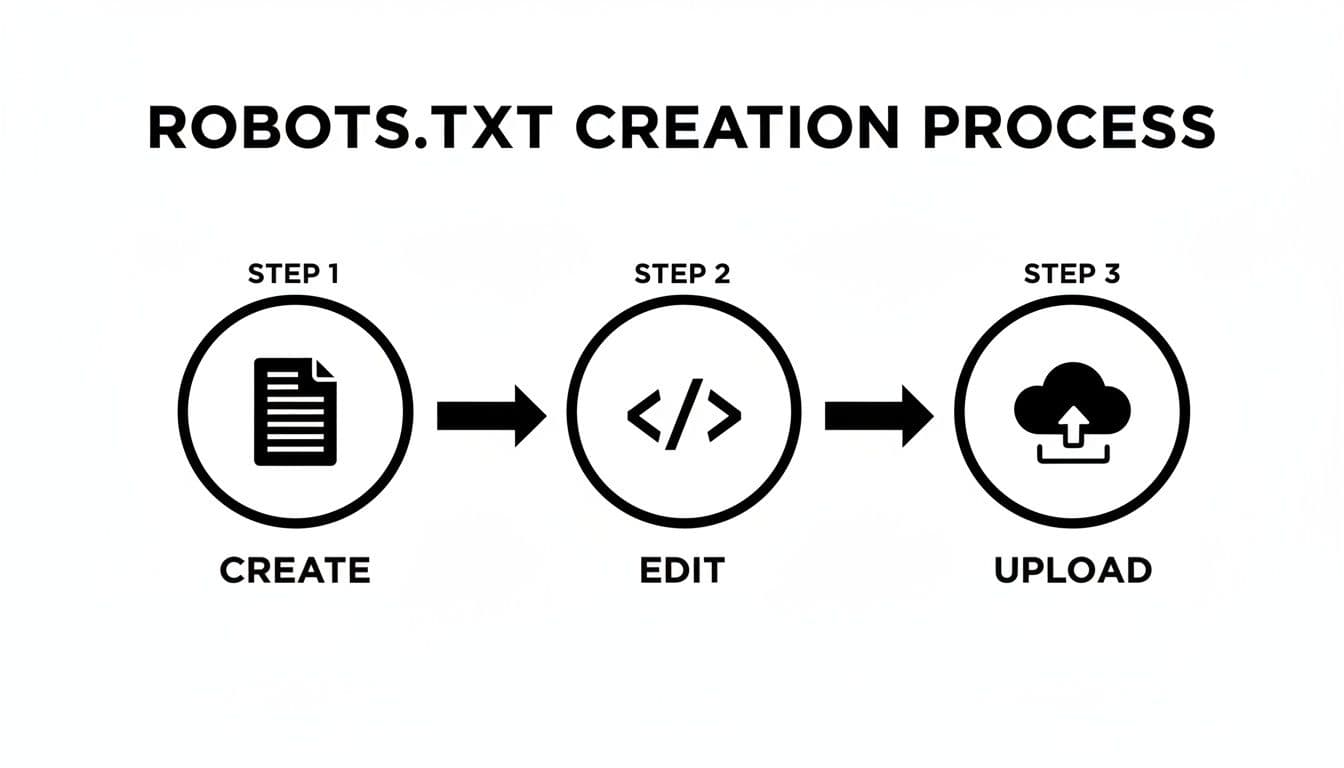
Crie um ficheiro de texto simples chamado robots.txt, adicione diretivas como User-agent: e Disallow:, e carregue-o para a raiz do seu site em https://yourdomain.com/robots.txt. Esse único ficheiro funciona como um conjunto de instruções simples para os rastreadores de motores de busca e outros bots.
Por que o seu ficheiro robots.txt é uma ferramenta crítica de SEO
Mexer no robots.txt pode parecer técnico, mas é o porteiro do seu website. Usado corretamente, preserva recursos do servidor e direciona os rastreadores para páginas de alto valor—melhorando a indexação e o posicionamento. O Robots Exclusion Protocol remonta aos primórdios da web, e o seu papel evoluiu para uma peça chave da infraestrutura do site.1
Um robots.txt focado ajuda-o a orientar os rastreadores para as páginas que trazem tráfego, leads e receita, mantendo-os afastados de áreas que desperdiçam o orçamento de rastreamento, como páginas de administração, resultados de pesquisa internos e versões duplicadas para impressão de páginas.
Um ficheiro robots.txt é mais do que uma lista de exclusão; é um guia estratégico para motores de busca. Diz-lhes onde gastar o seu tempo limitado no seu site, influenciando diretamente que páginas são indexadas e classificadas.
Em última análise, acertar no robots.txt significa melhor desempenho de SEO, recursos de servidor preservados e uma descoberta mais clara do seu conteúdo mais valioso.
Compreender a linguagem dos rastreadores web
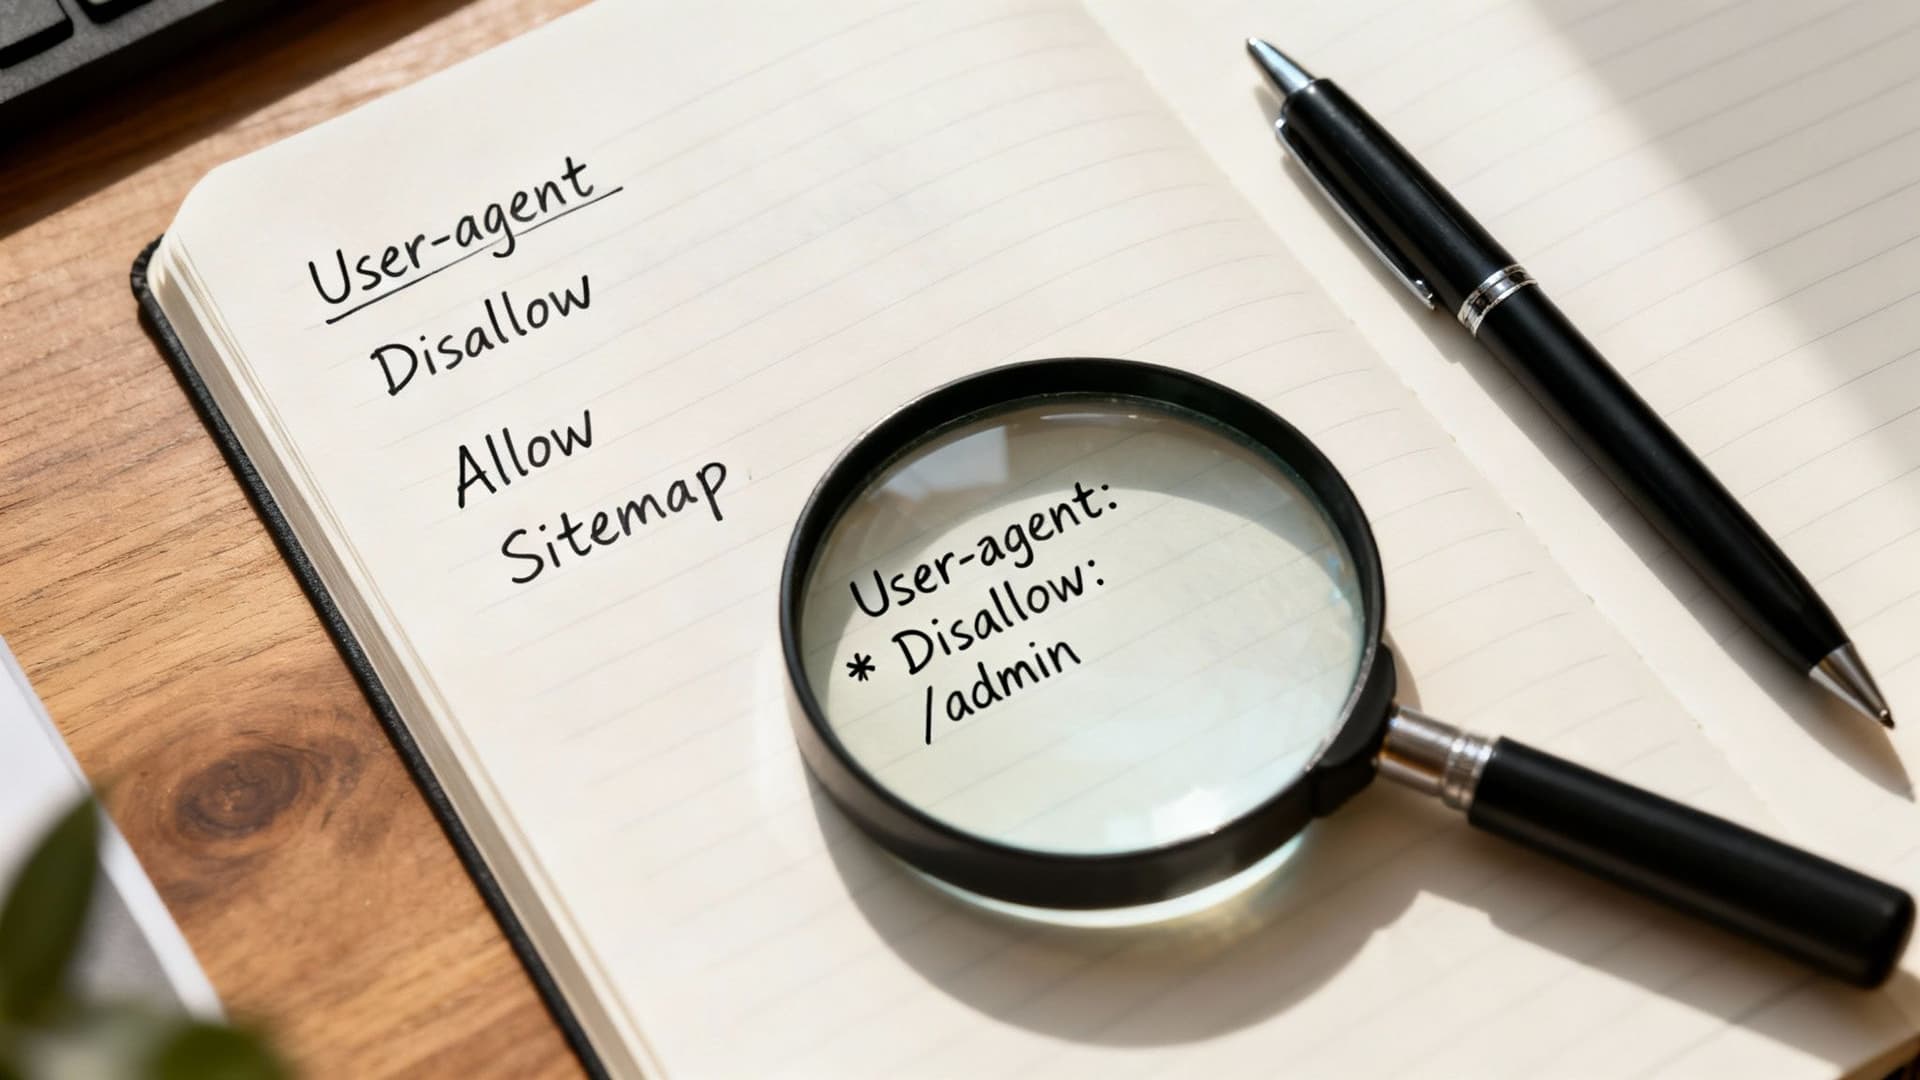
Robots.txt é uma curta conversa com os rastreadores. O ficheiro usa diretivas simples para indicar que portas estão abertas ou fechadas. Estes comandos são diretos e formam a base de uma estratégia saudável de SEO técnico.
Diretivas centrais do robots.txt explicadas
| Directive | O que faz | Quando usar |
|---|---|---|
| User-agent | Especifica a que rastreador as regras se aplicam. * é um curinga para todos os bots. | Use User-agent: * para regras gerais, ou especifique Googlebot ou Bingbot para instruções direcionadas. |
| Disallow | Diz aos bots para não rastrearem um ficheiro ou diretório específico. | Bloqueie páginas de login de administração (/wp-admin/), resultados de pesquisa internos ou páginas de agradecimento sem utilidade. |
| Allow | Anula um Disallow para uma subpasta ou ficheiro específico. | Permite um único ficheiro dentro de um diretório bloqueado. |
| Sitemap | Indica aos rastreadores o seu ficheiro sitemap XML para que possam descobrir páginas importantes. | Inclua sempre isto para acelerar a descoberta das páginas que pretende indexar. |
Estes comandos simples dão-lhe um controlo forte sobre o comportamento dos rastreadores. Dominá-los ajuda-o a criar um ficheiro robots.txt eficaz.
Colocando diretivas em prática
Se tiver uma ferramenta interativa importante—por exemplo, uma calculadora geradora de leads—pretende que os motores de busca a rastreiem e indexem. Ao mesmo tempo, vai querer bloquear páginas que não acrescentam valor SEO. Um robots.txt comum e prático parece com isto:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
Esta configuração usa User-agent: * para endereçar todos os bots, bloqueia algumas pastas não públicas comuns e aponta os rastreadores para o sitemap. É simples e eficiente.
Para saber mais sobre como os rastreadores se comportam, analise os registos do servidor e os dados de visitantes. Depois de entender que bots estão a aceder ao seu site, pode criar regras que apoiem os objetivos do seu negócio.
Um guia prático para criar manualmente o seu ficheiro robots.txt
Por vezes deve criar o ficheiro à mão. Use Notepad ou TextEdit, guarde o ficheiro como texto simples com o nome robots.txt (minúsculas), e carregue-o para a raiz do seu site via FTP ou o gestor de ficheiros do seu alojamento. Se o guardar como .docx ou .rtf, os rastreadores irão ignorá-lo.
Coloque-o em https://yourdomain.com/robots.txt. Carregá-lo para uma subpasta, como /blog/robots.txt, torna-o invisível para os rastreadores.
Criar regras para objetivos empresariais do mundo real
Exemplo: um site de serviços financeiros com uma Calculadora Hipotecária que gera leads. Quer essa ferramenta indexada, mas não quer áreas de administração ou páginas de agradecimento nos resultados de pesquisa. Defina as suas regras assim:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
Isto diz a todos os rastreadores que podem rastrear o site exceto /admin/ e a página de agradecimento, e aponta para um sitemap. Inclua uma linha de sitemap como esta para ajudar os rastreadores a encontrar páginas profundas ou importantes mais rapidamente.
Nota: A ordem importa em ficheiros mais complexos. Para regras sobrepostas de
AlloweDisallow, a regra mais específica deve vir primeiro para o Googlebot, caso contrário corre o risco de bloquear conteúdo involuntariamente.
Criar e testar o seu robots.txt é um passo central em qualquer auditoria técnica de SEO.
Gerir a nova vaga de rastreadores de IA e LLM
O panorama dos rastreadores inclui agora bots específicos de IA como GPTBot e Common Crawl. Estes rastreadores cresceram rapidamente, e muitos sites estão a ajustar regras para os tratar. Rastreadores de IA educados obedecem ao robots.txt, mas scrapers maliciosos podem não obedecer.2
Porque pode querer bloquear rastreadores de IA
Bloquear rastreadores de IA pode proteger conteúdo original de ser raspado e usado para treinar modelos sem atribuição ou compensação. Se construiu uma ferramenta online única, pode não querer que a sua lógica ou dados sejam recolhidos por terceiros. Pese os benefícios de visibilidade em plataformas orientadas por IA contra o risco de o seu conteúdo ser reutilizado.
Analisar ficheiros de registo ajuda a ver quais os bots que visitam o seu site e informa se deve bloqueá-los.3
Como bloquear bots comuns de IA
Adicione linhas User-agent específicas para cada rastreador que pretende bloquear. Exemplos incluem GPTBot, CCBot, Google-Extended e Anthropic-AI. Para bloquear um bot completamente:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Lembre-se, robots.txt é um sistema de honra. Rastreadores reputados respeitarão as suas regras, mas actores maliciosos podem ignorá-las. Para proteção mais forte, considere um Web Application Firewall (WAF) ou uma solução dedicada de gestão de bots.
Evitar erros comuns e dispendiosos no robots.txt
Uma única linha colocada no sítio errado pode desindexar acidentalmente todo o seu site. O erro clássico é Disallow: /, que diz a todos os rastreadores para não rastrearem nenhuma página. Se o seu site desaparecer subitamente dos resultados de pesquisa, verifique primeiro o robots.txt.
Bloquear ficheiros essenciais
Bloquear CSS ou JavaScript pode impedir o Google de renderizar páginas corretamente, o que prejudica o SEO. Por exemplo, não bloqueie /assets/js/ se o seu site depende de JavaScript para carregar conteúdo importante. Em vez disso, use Allow: para esses recursos quando necessário:
- Antes (incorreto):
Disallow: /assets/js/ - Depois (correto):
Allow: /assets/js/
Regras conflitantes e erros de sintaxe
As regras são lidas de cima para baixo, e regras mais específicas devem vir antes das mais gerais. Se quiser bloquear uma pasta /private/ mas permitir um único PDF dentro dela, coloque a regra Allow primeiro para o Googlebot:
Allow: /private/public-report.pdf
Disallow: /private/
Também tenha atenção a erros tipográficos. Uma diretiva mal escrita como "dissallow" é ignorada. Use o robots.txt Tester do Google Search Console antes de aplicar alterações.
Lembre-se, robots.txt é um pedido educado, não uma garantia. Muitos editores importantes estão a bloquear bots de treino de IA, mas raspadores determinados podem ignorar o seu ficheiro completamente.4
Perguntas comuns sobre ficheiros robots.txt
Robots.txt vs. noindex: qual é a diferença?
Robots.txt impede o rastreio, enquanto a tag noindex impede a indexação. Use robots.txt para evitar que rastreadores visitem secções como páginas de administração; use noindex em páginas que quer que sejam rastreadas mas não apareçam nos resultados de pesquisa, como landing pages temporárias.
Devo adicionar o meu sitemap ao ficheiro robots.txt?
Sim. Adicionar Sitemap: https://www.yourdomain.com/sitemap.xml ajuda os rastreadores a descobrir e indexar conteúdo com ligações profundas e de alto valor mais rapidamente. Se usar vários sitemaps, adicione uma linha Sitemap: por ficheiro.
O robots.txt pode impedir bots maliciosos e scrapers?
Robots.txt ajuda, mas não é infalível. É eficaz contra rastreadores bem-comportados, mas scrapers maliciosos muitas vezes ignoram-no. Para proteção robusta, combine robots.txt com controlos ao nível do servidor, um WAF e ferramentas de gestão de bots.
Pronto para aumentar o envolvimento e o SEO do seu site com ferramentas interativas? Com o MicroEstimates, pode criar e incorporar calculadoras personalizadas no seu site. Experimente estas ferramentas para apoiar geração de leads e envolvimento de utilizadores:
Perguntas rápidas — perguntas comuns dos leitores
Qual é o robots.txt mais simples para a maioria dos sites?
Comece com:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
Como bloqueio o GPTBot ou outros rastreadores de IA?
Adicione uma diretiva User-agent para cada rastreador e configure Disallow: / por baixo dela.
Como testo o meu robots.txt antes de o publicar?
Use o robots.txt Tester do Google Search Console e verifique os registos do servidor para confirmar o comportamento esperado.
1.
Robots Exclusion Protocol origin and history. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Reports on automated bot traffic and its share of web traffic. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Analysis and advice on managing AI crawlers and log-file analysis. https://developers.google.com/search/docs/advanced/robots/intro
4.
Coverage of publishers blocking AI training bots. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
Pronto para construir suas próprias ferramentas gratuitamente?
Junte-se a centenas de empresas que já usam ferramentas de estimação personalizadas para aumentar lucros e conquistar mais clientes
✨ Nenhuma programação necessária • 🚀 Pronto em minutos • 💸 Grátis para criar