Dowiedz się, jak wygenerować plik robots txt, aby kontrolować crawlery i zwiększyć techniczne SEO dzięki praktycznemu przewodnikowi krok po kroku.
January 11, 2026 (9mo ago)
Opanuj SEO: wygeneruj plik robots txt dzięki temu szybkiemu przewodnikowi
Dowiedz się, jak wygenerować plik robots txt, aby kontrolować crawlery i zwiększyć techniczne SEO dzięki praktycznemu przewodnikowi krok po kroku.
← Back to blog
Generowanie robots.txt: szybki przewodnik SEO
Podsumowanie: Dowiedz się, jak utworzyć i wdrożyć plik robots.txt, aby kontrolować crawlery, chronić treści i optymalizować crawl budget na podstawie praktycznych przykładów.
Wprowadzenie
Dobrze przygotowany plik robots.txt daje Ci kontrolę nad tym, które crawlery mogą uzyskiwać dostęp do Twojej witryny, pomaga chronić cenne treści i skupia crawl budget na stronach, które mają znaczenie. Ten przewodnik pokazuje jasne, praktyczne kroki tworzenia, testowania i aktualizowania robots.txt, aby wyszukiwarki i uprzejme boty zachowywały się tak, jak chcesz.
Aby zacząć
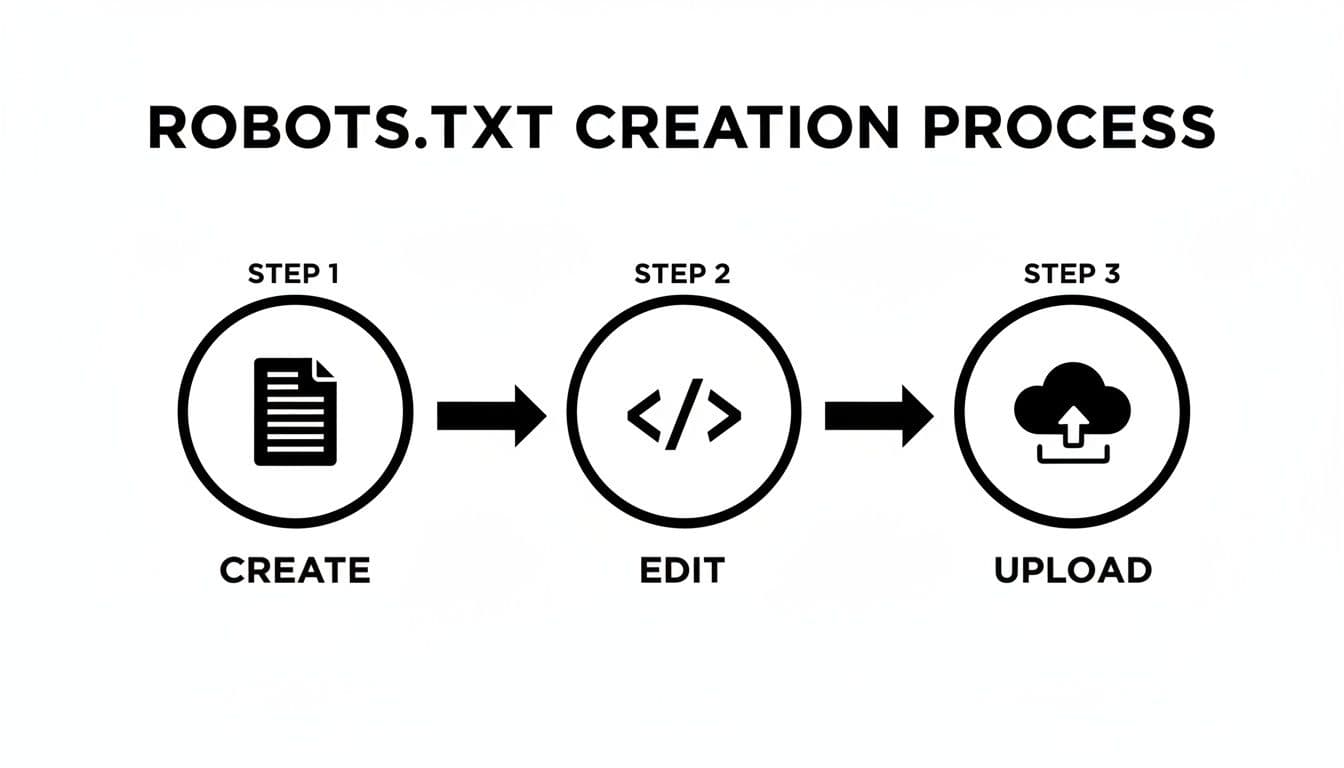
Utwórz plik tekstowy o nazwie robots.txt, dodaj dyrektywy takie jak User-agent: i Disallow:, a następnie prześlij go do katalogu głównego swojej witryny pod adresem https://yourdomain.com/robots.txt. Ten pojedynczy plik działa jak prosty zestaw poleceń dla crawlerów wyszukiwarek i innych botów.
Dlaczego Twój plik robots.txt jest krytycznym narzędziem SEO
Majstrowanie przy robots.txt może wydawać się techniczne, ale to strażnik Twojej witryny. Użyte prawidłowo, zachowuje zasoby serwera i kieruje crawlery do stron o wysokiej wartości — poprawiając indeksację i pozycjonowanie. Protokół wykluczania robotów (Robots Exclusion Protocol) sięga początków sieci, a jego rola ewoluowała do kluczowego elementu infrastruktury witryny.1
Skoncentrowany robots.txt pomaga skierować crawlery na strony przynoszące ruch, leady i przychody, jednocześnie trzymając je z dala od obszarów marnujących crawl budget, takich jak strony administracyjne, wewnętrzne wyniki wyszukiwania czy duplikaty wersji do druku.
Plik robots.txt to więcej niż lista wykluczeń; to strategiczny przewodnik dla wyszukiwarek. Mówi im, gdzie przeznaczyć ich ograniczony czas na Twojej stronie, bezpośrednio wpływając na to, które strony zostaną zaindeksowane i ocenione.
Ostatecznie prawidłowe ustawienie robots.txt oznacza lepsze wyniki SEO, zachowane zasoby serwera i jaśniejsze odkrywanie Twoich najcenniejszych treści.
Zrozumieć język crawlerów sieciowych
Robots.txt to krótka rozmowa z crawlerami. Plik używa prostych dyrektyw, aby wskazać, które drzwi są otwarte, a które zamknięte. Te polecenia są przejrzyste i stanowią fundament zdrowej strategii technicznego SEO.
Wyjaśnienie podstawowych dyrektyw robots.txt
| Dyrektywa | Co robi | Kiedy używać jej |
|---|---|---|
| User-agent | Określa, do którego crawlera odnoszą się zasady. * to wildcard dla wszystkich botów. | Użyj User-agent: * dla ogólnych zasad, lub określ Googlebot czy Bingbot dla instrukcji ukierunkowanych. |
| Disallow | Mówi botom, aby nie crawlowali konkretnego pliku lub katalogu. | Blokuj strony logowania administracji (/wp-admin/), wewnętrzne wyniki wyszukiwania lub nieprzydatne strony z podziękowaniem. |
| Allow | Nadpisuje Disallow dla konkretnego podfolderu lub pliku. | Zezwól na pojedynczy plik wewnątrz zablokowanego katalogu. |
| Sitemap | Wskazuje crawlerom na plik sitemap XML, aby mogły odkryć ważne strony. | Zawsze dołączaj tę dyrektywę, aby przyspieszyć odkrywanie stron, które chcesz indeksować. |
Te proste polecenia dają Ci silną kontrolę nad zachowaniem crawlerów. Opanowanie ich pomaga stworzyć skuteczny plik robots.txt.
Zastosowanie dyrektyw w praktyce
Jeśli masz ważne narzędzie interaktywne — na przykład kalkulator generujący leady — chcesz, żeby wyszukiwarki go crawlowaly i indeksowały. Jednocześnie zablokujesz strony, które nie dodają wartości SEO. Typowy, praktyczny robots.txt wygląda tak:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
To ustawienie używa User-agent: *, aby kierować wszystkie boty, blokuje kilka typowych folderów niepublicznych i wskazuje crawlerom mapę strony. Jest czyste i efektywne.
Aby dowiedzieć się więcej o zachowaniu crawlerów, analizuj logi serwera i dane odwiedzin. Gdy zrozumiesz, które boty odwiedzają Twoją witrynę, możesz tworzyć zasady wspierające cele Twojej firmy.
Praktyczny przewodnik tworzenia pliku robots.txt ręcznie
Czasami warto stworzyć plik ręcznie. Użyj Notatnika lub TextEdit, zapisz plik jako zwykły tekst o nazwie robots.txt (małymi literami) i prześlij go do katalogu głównego witryny przez FTP lub menedżera plików hosta. Jeśli zapiszesz go jako .docx lub .rtf, crawlery go zignorują.
Umieść go pod adresem https://yourdomain.com/robots.txt. Wgrywanie go do podfolderu, np. /blog/robots.txt, uczyni go niewidocznym dla crawlerów.
Tworzenie reguł odpowiadających realnym celom biznesowym
Przykład: serwis finansowy z kalkulatorem kredytowym generującym leady. Chcesz, aby to narzędzie było indeksowane, ale nie chcesz, aby w wynikach wyszukiwania pojawiały się obszary administracyjne lub strony z podziękowaniem. Ustaw reguły tak:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
To mówi wszystkim crawlerom, że mogą crawlowac stronę z wyjątkiem /admin/ i strony z podziękowaniem, oraz wskazuje im mapę strony. Dołącz linię sitemap, aby pomóc crawlerom szybciej znaleźć głębokie lub ważne strony.
Uwaga: Kolejność ma znaczenie w bardziej rozbudowanych plikach. Przy nakładających się regułach
AllowiDisallow, najbardziej szczegółowa reguła powinna pojawić się pierwsza dla Googlebota, w przeciwnym razie ryzykujesz niezamierzone zablokowanie treści.
Tworzenie i testowanie robots.txt to kluczowy krok w każdym audycie technicznego SEO.
Zarządzanie nową falą crawlerów AI i modeli LLM
Krajobraz crawlerów obejmuje teraz boty specyficzne dla AI, takie jak GPTBot i Common Crawl. Te crawlery szybko się rozwinęły i wiele witryn dostosowuje zasady, aby je uwzględnić. Uprzejme crawlery AI będą przestrzegać robots.txt, ale złośliwe scraper’y mogą tego nie robić.2
Dlaczego możesz zablokować crawlery AI
Blokowanie crawlerów AI może chronić oryginalne treści przed zeskrobywaniem i wykorzystaniem do trenowania modeli bez przypisania autorstwa czy rekompensaty. Jeśli zbudowałeś unikalne narzędzie online, być może nie chcesz, aby jego logika lub dane były zbierane przez strony trzecie. Rozważ korzyści z widoczności na platformach napędzanych AI w porównaniu z ryzykiem ponownego wykorzystania Twoich treści.
Analiza plików logów pomaga zobaczyć, które boty odwiedzają Twoją witrynę i informuje, czy je zablokować.3
Jak zablokować popularne boty AI
Dodaj konkretne linie User-agent dla każdego crawlера, którego chcesz zablokować. Przykłady to GPTBot, CCBot, Google-Extended i Anthropic-AI. Aby całkowicie zablokować bota:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Pamiętaj, że robots.txt to system honorowy. Renomowane crawlery będą respektować Twoje zasady, ale złośliwi aktorzy mogą je zignorować. Dla silniejszej ochrony rozważ zaporę aplikacji webowej (WAF) lub dedykowane rozwiązanie do zarządzania botami.
Unikanie częstych i kosztownych błędów w robots.txt
Pojedyncza źle umieszczona linia może przypadkowo zdeindeksować całą witrynę. Klasycznym błędem jest Disallow: /, który mówi wszystkim crawlerom, aby nie crawlowali żadnych stron. Jeśli Twoja witryna nagle znika z wyników wyszukiwania, najpierw sprawdź robots.txt.
Blokowanie istotnych plików
Blokowanie CSS lub JavaScript może uniemożliwić Google poprawne renderowanie stron, co szkodzi SEO. Na przykład nie blokuj /assets/js/, jeśli Twoja strona polega na JavaScript do ładowania ważnych treści. Zamiast tego użyj Allow: dla tych zasobów, gdy to konieczne:
- Przed (nieprawidłowe):
Disallow: /assets/js/ - Po (prawidłowe):
Allow: /assets/js/
Konfliktujące reguły i błędy składniowe
Reguły czytane są od góry do dołu, a bardziej szczegółowe reguły powinny być przed szerszymi. Jeśli chcesz zablokować folder /private/, ale zezwolić na pojedynczy plik PDF w nim, umieść regułę Allow najpierw dla Googlebota:
Allow: /private/public-report.pdf
Disallow: /private/
Zwracaj też uwagę na literówki. Źle zapisane polecenie, takie jak "dissallow", jest ignorowane. Przed wdrożeniem zmian użyj testera robots.txt w Google Search Console.
Pamiętaj, robots.txt to uprzejma prośba, nie gwarancja. Wiele dużych wydawców blokuje boty szkolące AI, ale zdeterminowani scraperzy mogą zignorować Twój plik całkowicie.4
Często zadawane pytania dotyczące plików robots.txt
Robots.txt vs. noindex: jaka jest różnica?
Robots.txt zatrzymuje crawling, podczas gdy tag noindex zatrzymuje indeksowanie. Użyj robots.txt, aby zapobiec odwiedzinom crawlerów w sekcjach takich jak strony administracyjne; użyj noindex na stronach, które chcesz, aby były crawlowane, ale nie pojawiały się w wynikach wyszukiwania, takich jak tymczasowe landing page.
Czy powinienem dodać mapę strony do pliku robots.txt?
Tak. Dodanie Sitemap: https://www.yourdomain.com/sitemap.xml pomaga crawlerom szybciej odkryć i zaindeksować głęboko powiązane, wartościowe treści. Jeśli używasz wielu map stron, dodaj jedną linię Sitemap: dla każdego pliku.
Czy robots.txt może zatrzymać złe boty i scraperów?
Robots.txt pomaga, ale nie jest niezawodny. Działa przeciwko dobrze zachowującym się crawlerom, ale złośliwi scraperzy często go ignorują. Dla solidnej ochrony łącz robots.txt z kontrolami na poziomie serwera, WAF i narzędziami do zarządzania botami.
Gotowy, aby zwiększyć zaangażowanie i SEO swojej strony za pomocą narzędzi interaktywnych? Z MicroEstimates możesz budować i osadzać niestandardowe kalkulatory na swojej stronie. Wypróbuj te narzędzia, aby wspierać generowanie leadów i zaangażowanie użytkowników:
Szybkie pytania i odpowiedzi — częste pytania czytelników
Jaki jest najprostszy robots.txt dla większości stron?
Zacznij od:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
Jak zablokować GPTBot lub inne crawlery AI?
Dodaj dyrektywę User-agent dla każdego crawlera i ustaw Disallow: / pod nią.
Jak przetestować robots.txt przed wdrożeniem?
Użyj testera robots.txt w Google Search Console i sprawdź logi serwera, aby potwierdzić oczekiwane zachowanie.
1.
Pochodzenie i historia protokołu Robots Exclusion. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Raporty o automatycznym ruchu botów i jego udziale w ruchu w sieci. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Analiza i porady dotyczące zarządzania crawlerami AI i analizy plików logów. https://developers.google.com/search/docs/advanced/robots/intro
4.
Omówienie wydawców blokujących boty szkolące AI. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
Gotowy, aby zbudować własne narzędzia za darmo?
Dołącz do setek firm, które już używają niestandardowych narzędzi do szacowania, aby zwiększać zyski i zdobywać więcej klientów
✨ Kodowanie nie wymagane • 🚀 Gotowe w minuty • 💸 Tworzenie za darmo