Bądźmy szczerzy: wiele osób uważa pliki dziennika za techniczny szum, który zostawia się zespołowi IT. W rzeczywistości to zapis każdego żądania do serwera — w tym wizyt od crawlerów, takich jak Googlebot — który odsłania, jak wyszukiwarki rzeczywiście widzą Twoją stronę. Analiza logów pozwala zamienić przypuszczenia w konkretne dane i szybciej wykrywać problemy wpływające na widoczność.
December 24, 2025 (9mo ago) — last updated August 30, 2026 (1mo ago)
Analiza logów dla SEO — praktyczny przewodnik
Zdobądź praktyczne wskazówki z analizy plików dziennika: wykrywanie marnotrawstwa budżetu crawlowania, naprawa błędów i poprawa indeksowania.
← Back to blog
Praktyczny przewodnik po analizie plików dziennika dla SEO
Podsumowanie: Odkryj potężne informacje o SEO i wydajności dzięki analizie plików dziennika. Ten przewodnik pokazuje, jak znaleźć marnotrawstwo budżetu crawlowania, naprawić błędy i poprawić swoje pozycje.
Wprowadzenie
Bądźmy szczerzy: wiele osób uważa pliki dziennika za techniczny szum, który zostawia się zespołowi IT. W rzeczywistości to zapis każdego żądania do serwera — w tym wizyt od crawlerów, takich jak Googlebot — który odsłania, jak wyszukiwarki rzeczywiście widzą Twoją stronę. Analiza logów pozwala zamienić przypuszczenia w konkretne dane i szybciej wykrywać problemy wpływające na widoczność.
Dlaczego analiza logów to Twoja przewaga SEO
Narzędzia analityczne pokazują, co robią użytkownicy po wejściu na stronę. Logi serwera pokazują, czy roboty w ogóle docierają do Twoich najważniejszych stron. Jeśli crawlery tracą czas na niskowartościowych URL-ach lub natrafiają na błędy, Twoje wysiłki contentowe nie przyniosą efektu.
Analiza logów pozwala między innymi:
- wykryć marnotrawstwo budżetu crawlowania;
- znaleźć ukryte błędy 4xx/5xx;
- zweryfikować skuteczność zmian technicznych (migracje, robots.txt, sitemap);
- zrozumieć, które sekcje serwisu crawlerzy uznają za ważne.
Pliki dziennika to pełny zapis żądań obsłużonych przez serwer — to nie próbka, lecz kompletna historia, którą warto wykorzystać przy podejmowaniu decyzji SEO.
Pliki dziennika to obiektywny zapis — zamiast zgadywać, zobaczysz dokładne czasy wizyt crawlerów i wzorce ich zachowania.
Zbieranie rozproszonych logów w jednym miejscu
Pierwszy krok to znalezienie i scentralizowanie logów. W realnych środowiskach logi są rozproszone: serwery WWW, aplikacje, CDN, zapory i usługi chmurowe. Analiza pojedynczych plików uniemożliwia wykrycie trendów na poziomie całej witryny.
Typowe lokalizacje:
- Nginx: zwykle w /var/log/nginx/access.log i /var/log/nginx/error.log
- Apache: często w /var/log/apache2/ (Debian) lub /var/log/httpd/ (Red Hat)
Nowoczesne stacki wymagają uwzględnienia logów CDN, WAF i load balancerów. Centralizacja ułatwia zapytania w całej infrastrukturze i śledzenie ścieżek żądań od CDN do aplikacji.

Jak scentralizować logi
Użyj lekkiego shippera (np. Filebeat) do przesyłania linii logów do centralnego systemu. Open-source ELK (Elastic Stack) jest popularną opcją do samodzielnego hostingu, a rozwiązania zarządzane oferują prostsze wdrożenie2. Scentralizowane logowanie pozwala wykrywać anomalie, które w izolacji są niewidoczne.
Wyzwania przy zbieraniu
- niezgodne formaty logów;
- duży wolumen danych (GB–TB dziennie);
- kwestie bezpieczeństwa i prywatności.
Zbuduj pipeline do zbierania, parsowania i zabezpieczania logów, aby dane stały się wiarygodne i użyteczne.
Parsowanie: przekształcanie surowych linii w dane
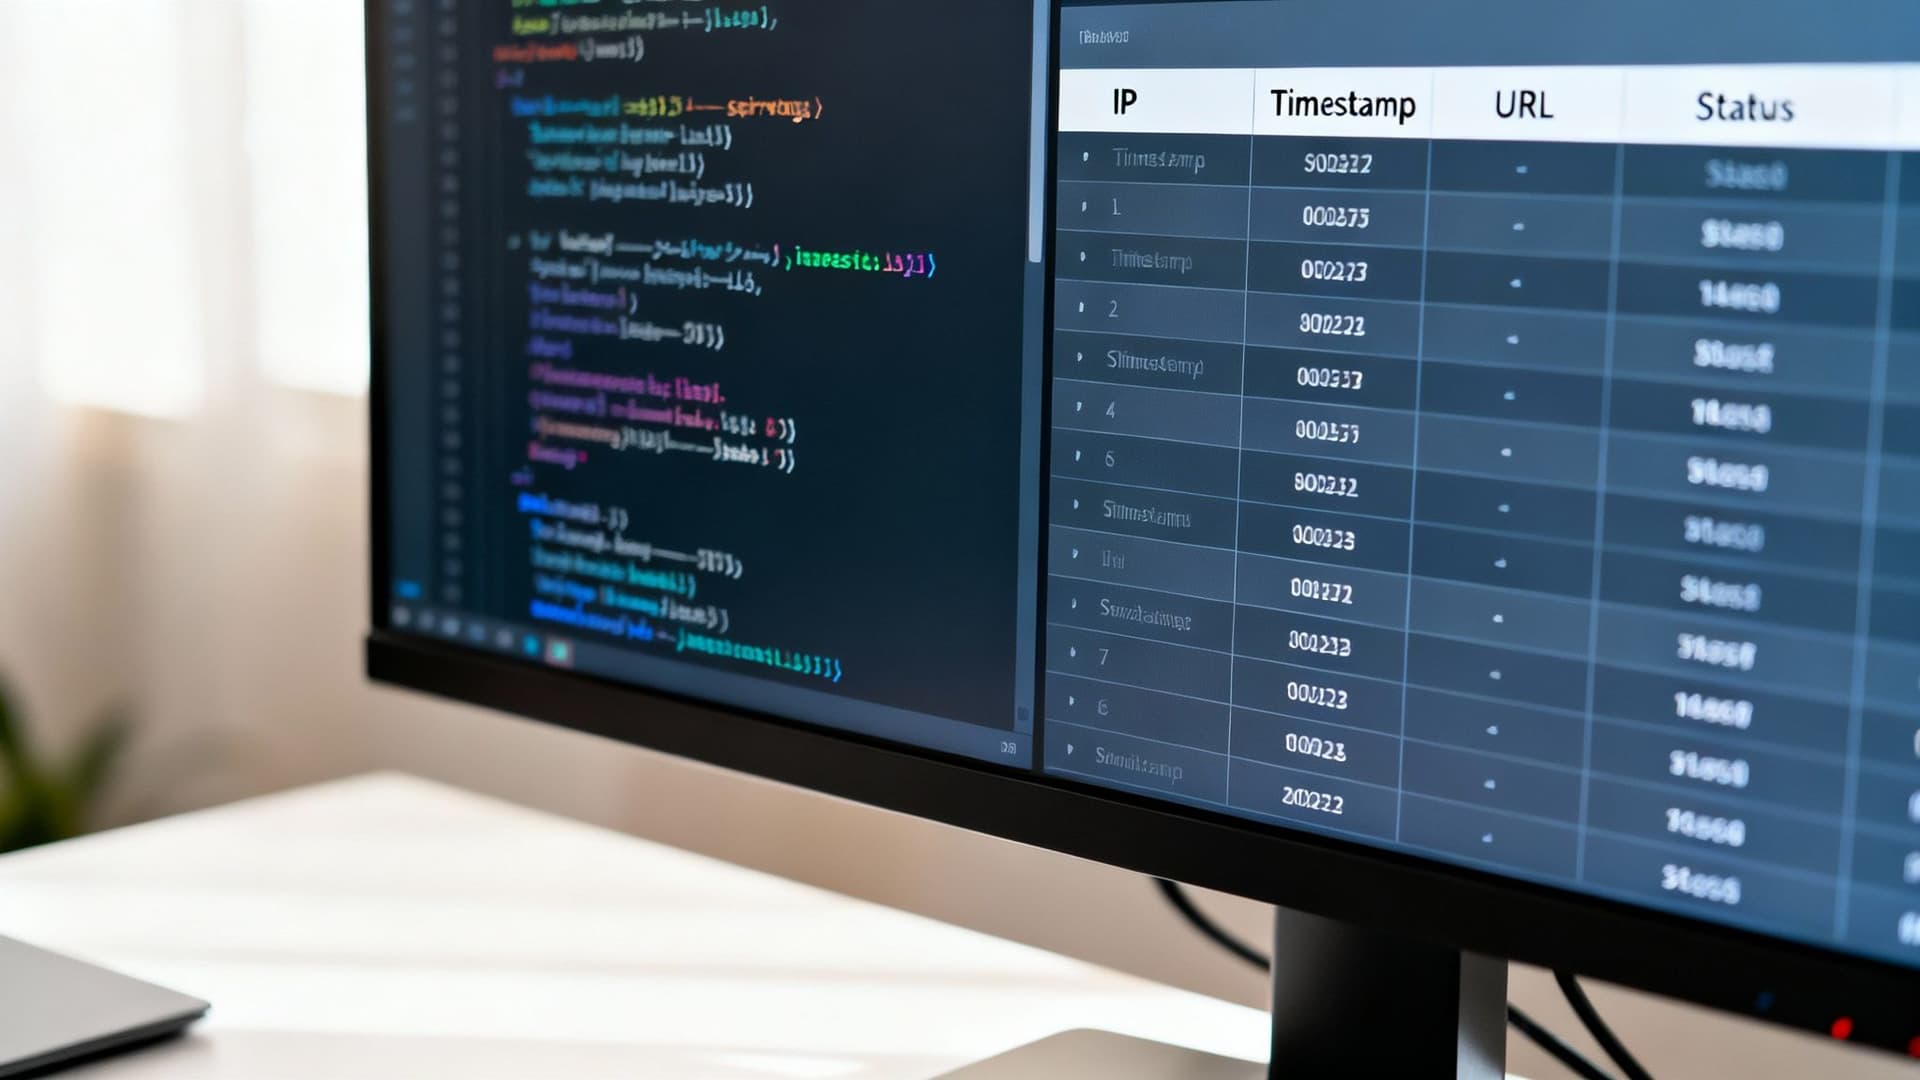
Po scentralizowaniu logów parsowanie zmienia surowe linie w pola: ip, timestamp, request_url, status_code, user_agent, time_taken. To pozwala filtrować i tworzyć pulpity oraz raporty przydatne dla zespołów SEO i inżynierii.
Przykład wpisu Nginx i jego pola:
192.168.1.1 - - [10/Oct/2023:13:55:36 +0000] "GET /products/widget HTTP/1.1" 200 1234 "https://example.com/" "Mozilla/5.0..."
Można to zparsować na IP, znacznik czasu, żądanie, status, bajty, referrer i user-agent. Wiele platform udostępnia gotowe wzorce (np. Grok), które przyspieszają pracę i zmniejszają potrzebę tworzenia skomplikowanych wyrażeń regularnych.
Jak wyciągnąć praktyczne wnioski SEO i wydajnościowe
Gdy logi są ustrukturyzowane, możesz szybciej znajdować problemy i potwierdzać efekty zmian.
Wykrywanie marnotrawstwa budżetu crawlowania
Budżet crawlowania jest ograniczony. Sprawdź, czy Googlebot nie poświęca czasu na strony o niskiej wartości, parametry URL czy łańcuchy przekierowań. Naprawa takich wzorców poprawia indeksowanie stron generujących ruch i przychody.
Lokalizowanie wąskich gardeł wydajnościowych
Logi z polem time-taken lub podobnym ujawniają powolne endpointy. Filtruj żądania o dużej latencji, aby ustalić priorytety prac inżynieryjnych. Dane z logów pomagają zbudować biznesowy argument za inwestycją w infrastrukturę.
Weryfikacja zmian technicznych
Po aktualizacji robots.txt, sitemap lub migracji użyj logów, by potwierdzić efekty: czy crawlery przestały odwiedzać zablokowane URL-e? Czy nowe sekcje są crawlowane? Ta pętla informacji zwrotnej zamienia przypuszczenia w fakty.
Adopcja narzędzi do analizy logów jest wysoka w przedsiębiorstwach — platformy takie jak Splunk i Elastic dominują na rynku, bo logi są kluczowe dla operacji i bezpieczeństwa32.
Pulpity i alerty: zautomatyzuj wykrywanie problemów
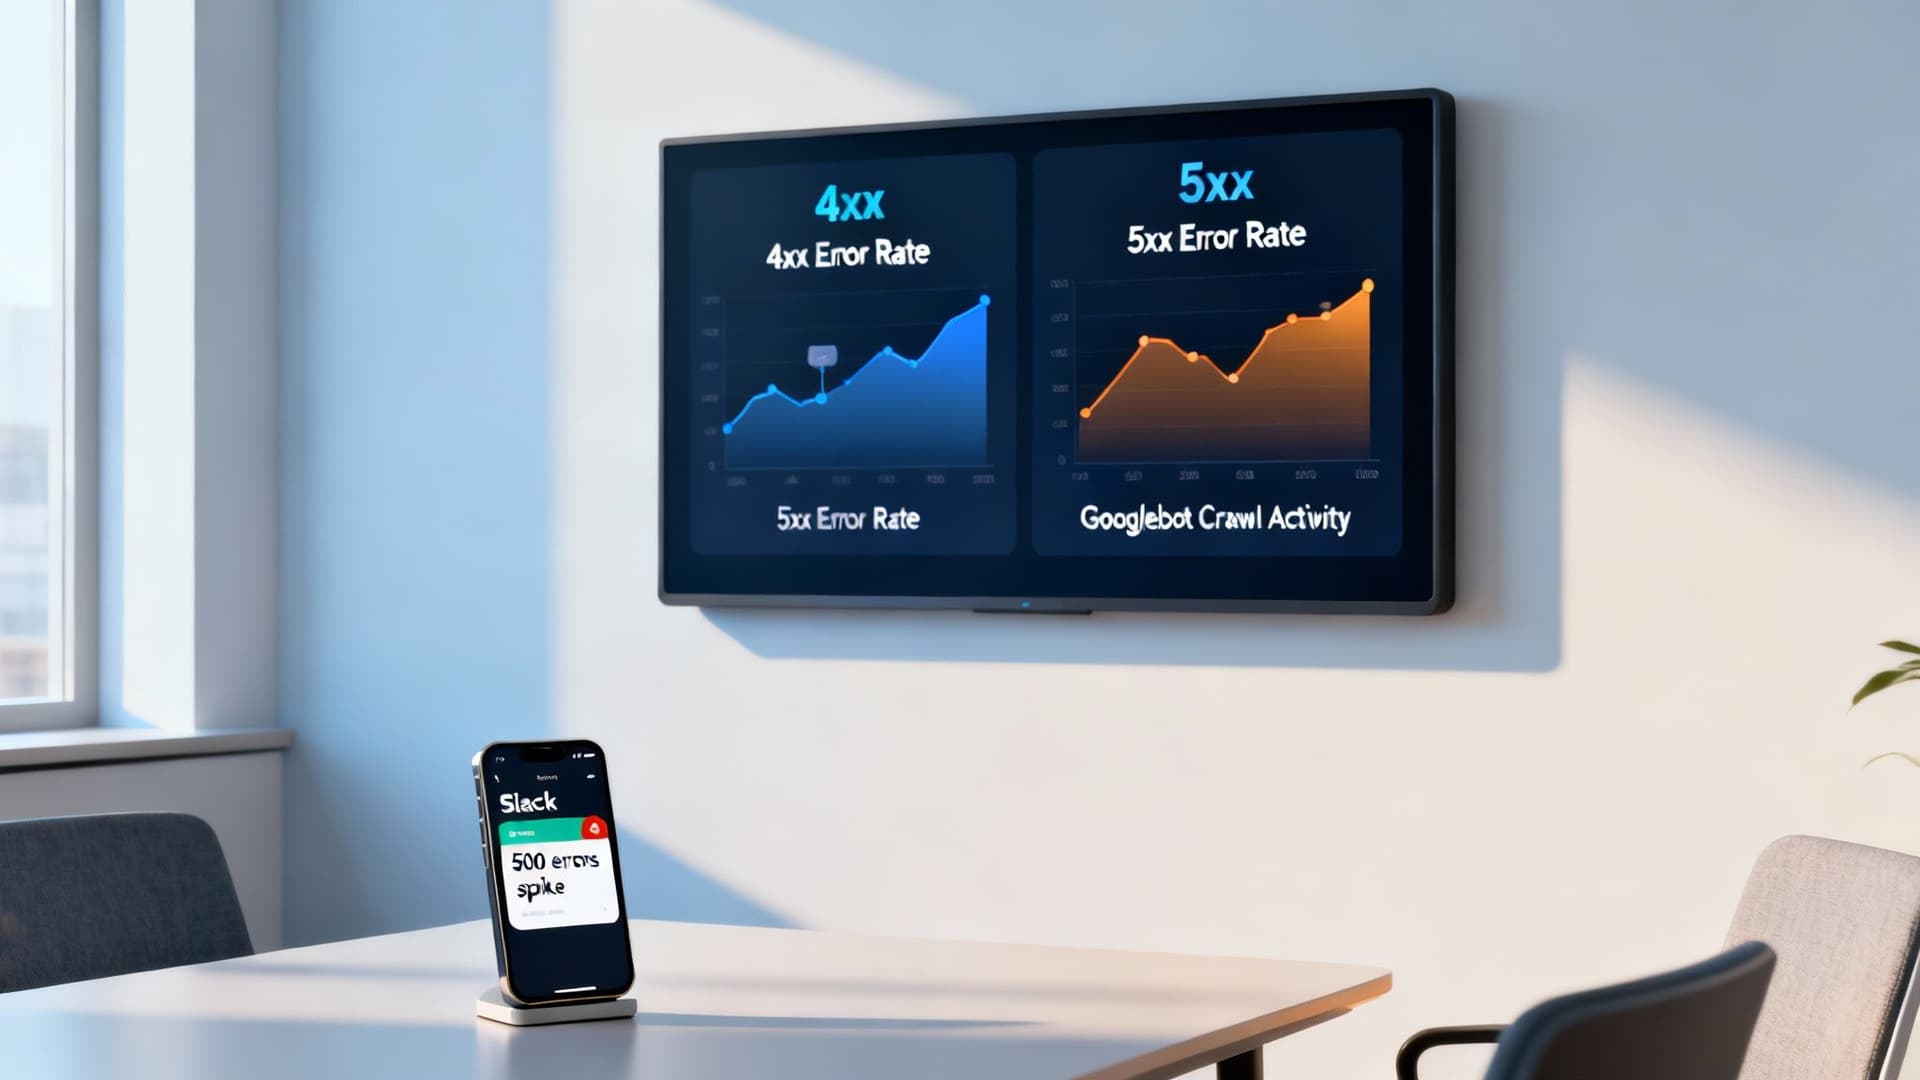
Ręczne przeglądanie logów jest wolne. Zbuduj pulpity i alerty, by reagować zanim klienci zauważą problemy.
Przykładowe wizualizacje:
- trendy kodów statusu (2xx, 3xx, 4xx, 5xx);
- aktywność Googlebot (żądania na godzinę/dzień);
- najwolniejsze strony (top 10 wg średniego czasu odpowiedzi).
Przykłady reguł alarmowych:
- IF błędy 500 > 50 w ciągu 5 minut, THEN opublikuj na #dev-alerts;
- IF żądania Googlebot spadną o 80% dziennie, THEN powiadom SEO.
Alerty pozwalają reagować w minutach, nie godzinach.
Zarządzanie kosztami i przechowywanie logów w skali
Duży ruch oznacza dużą objętość logów. Inteligentne polityki zmniejszają koszty bez utraty istotnych danych.
Strategie redukcji:
- przefiltruj hałaśliwe wpisy na shipperze (np. health checki);
- próbkowanie logów niekrytycznych;
- poziomy przechowywania: gorące logi dostępne 30 dni, starsze do zimnego magazynu.
Modeluj oszczędności wynikające z redukcji zindeksowanego wolumenu, aby wykazać ROI — już 20% cięcie może dać zauważalny efekt w kosztach miesięcznych.
Najczęściej zadawane pytania — szybkie odpowiedzi
P: Ile danych z logów powinienem przechowywać? O: Przechowuj logi możliwe do szybkiego przeszukania przez co najmniej 30 dni; starsze archiwizuj do zimnego magazynu dla analiz trendów lub zgodności.
P: Czy analiza w czasie rzeczywistym jest konieczna? O: Nie zawsze. Dla operacji i bezpieczeństwa czas rzeczywisty bywa kluczowy. Dla większości wniosków SEO wystarczają kontrole dzienne lub cotygodniowe.
P: Czy analiza logów może oszczędzić firmie pieniądze? O: Tak. Lepsze wykorzystanie budżetu crawlowania, szybsza strona i redukcja objętości logów obniżają koszty i poprawiają przychody z ruchu organicznego.
Gotowy, by przekształcić wnioski w działania? Użyj scentralizowanych logów i odpowiednich narzędzi, aby skwantyfikować wpływ poprawek technicznych i zbudować biznesowy argument oparty na dowodach. Na przykład możesz użyć Business Valuation Estimator do modelowania wpływu finansowego.
Szybkie Q&A — trzy kluczowe pytania i odpowiedzi
P: Jak szybko zobaczę korzyści z analizy logów? O: Niektóre poprawki, jak naprawa łańcuchów przekierowań czy usunięcie niskowartościowych stron, mogą poprawić indeksowanie w ciągu dni; większe prace infrastrukturalne wymagają więcej czasu.
P: Od czego zacząć, gdy nigdy nie analizowałem logów? O: Scentralizuj logi, sparsuj podstawowe pola (IP, timestamp, request_url, status, user_agent) i zbuduj proste pulpity i alerty.
P: Jakie metryki warto śledzić najpierw? O: Trendy kodów statusu, aktywność Googlebot i najwolniejsze strony to dobre punkty startowe.
1.
Technavio, Log Management Market Analysis
2.
Elastic, What is the ELK Stack?
3.
Splunk, Splunk Home
4.
Sumo Logic, How organizations tackle log monitoring at scale
Gotowy, aby zbudować własne narzędzia za darmo?
Dołącz do setek firm, które już używają niestandardowych narzędzi do szacowania, aby zwiększać zyski i zdobywać więcej klientów
✨ Kodowanie nie wymagane • 🚀 Gotowe w minuty • 💸 Tworzenie za darmo