よく設計された robots.txt は、どのクローラーがサイトにアクセスできるかを管理し、重要ページへクロール予算を集中させるための強力なツールです。本ガイドは、作成・テスト・運用までの実践手順と具体例をわかりやすく示します。初心者でもすぐに使えるサンプルと注意点を含みます。
January 11, 2026 (9mo ago) — last updated October 16, 2026 (7d ago)
robots.txt 作成クイックガイド(クロール制御)
robots.txt の作成・テスト・運用を具体例で解説。クロール制御、クロール予算最適化、AIクローラー対応まで網羅。
← Back to blog
Generate robots.txt: Quick SEO Guide
Summary: クローラーを制御し、コンテンツを保護し、クロール予算を最適化するための robots.txt ファイルを作成・デプロイする方法を、実践的な例とともに学びます。
Introduction
よく設計された robots.txt ファイルがあれば、どのクローラーがサイトにアクセスできるかを明確に管理でき、価値あるページへクロール予算を集中させられます。本ガイドは、初心者でもすぐに使える実践手順、テスト方法、運用上の注意点を具体例を交えてまとめています。実務で役立つ簡潔なチェックリストとサンプルを用意しているので、手を動かしながら学べます。
To get started
robots.txt という名前のプレーンテキストファイルを作成し、User-agent: や Disallow: のようなディレクティブを追加して、サイトのルートである https://yourdomain.com/robots.txt にアップロードします。その単一ファイルが検索エンジンのクローラーやその他のボット向けの基本的な指示セットとして機能します。
Why your robots.txt file is a critical SEO tool
robots.txt を正しく使うことは、サーバー資源の節約と重要ページへのクロール集中という点で大きな効果があります。Robots Exclusion Protocol は初期のウェブから存在し、現在もクローラーの基本的礼儀として機能しています1。調査によれば、ボットは総トラフィックの約40%に達することがあると報告されており、どのボットが来ているか把握することは運用上重要です2。
“robots.txt ファイルは単なる除外リストではなく、検索エンジンに対する戦略的なガイドです。”
適切な設定は、SEO パフォーマンスの向上、サーバー資源の節約、そして最も価値あるコンテンツの発見性向上につながります。
Understanding the language of web crawlers
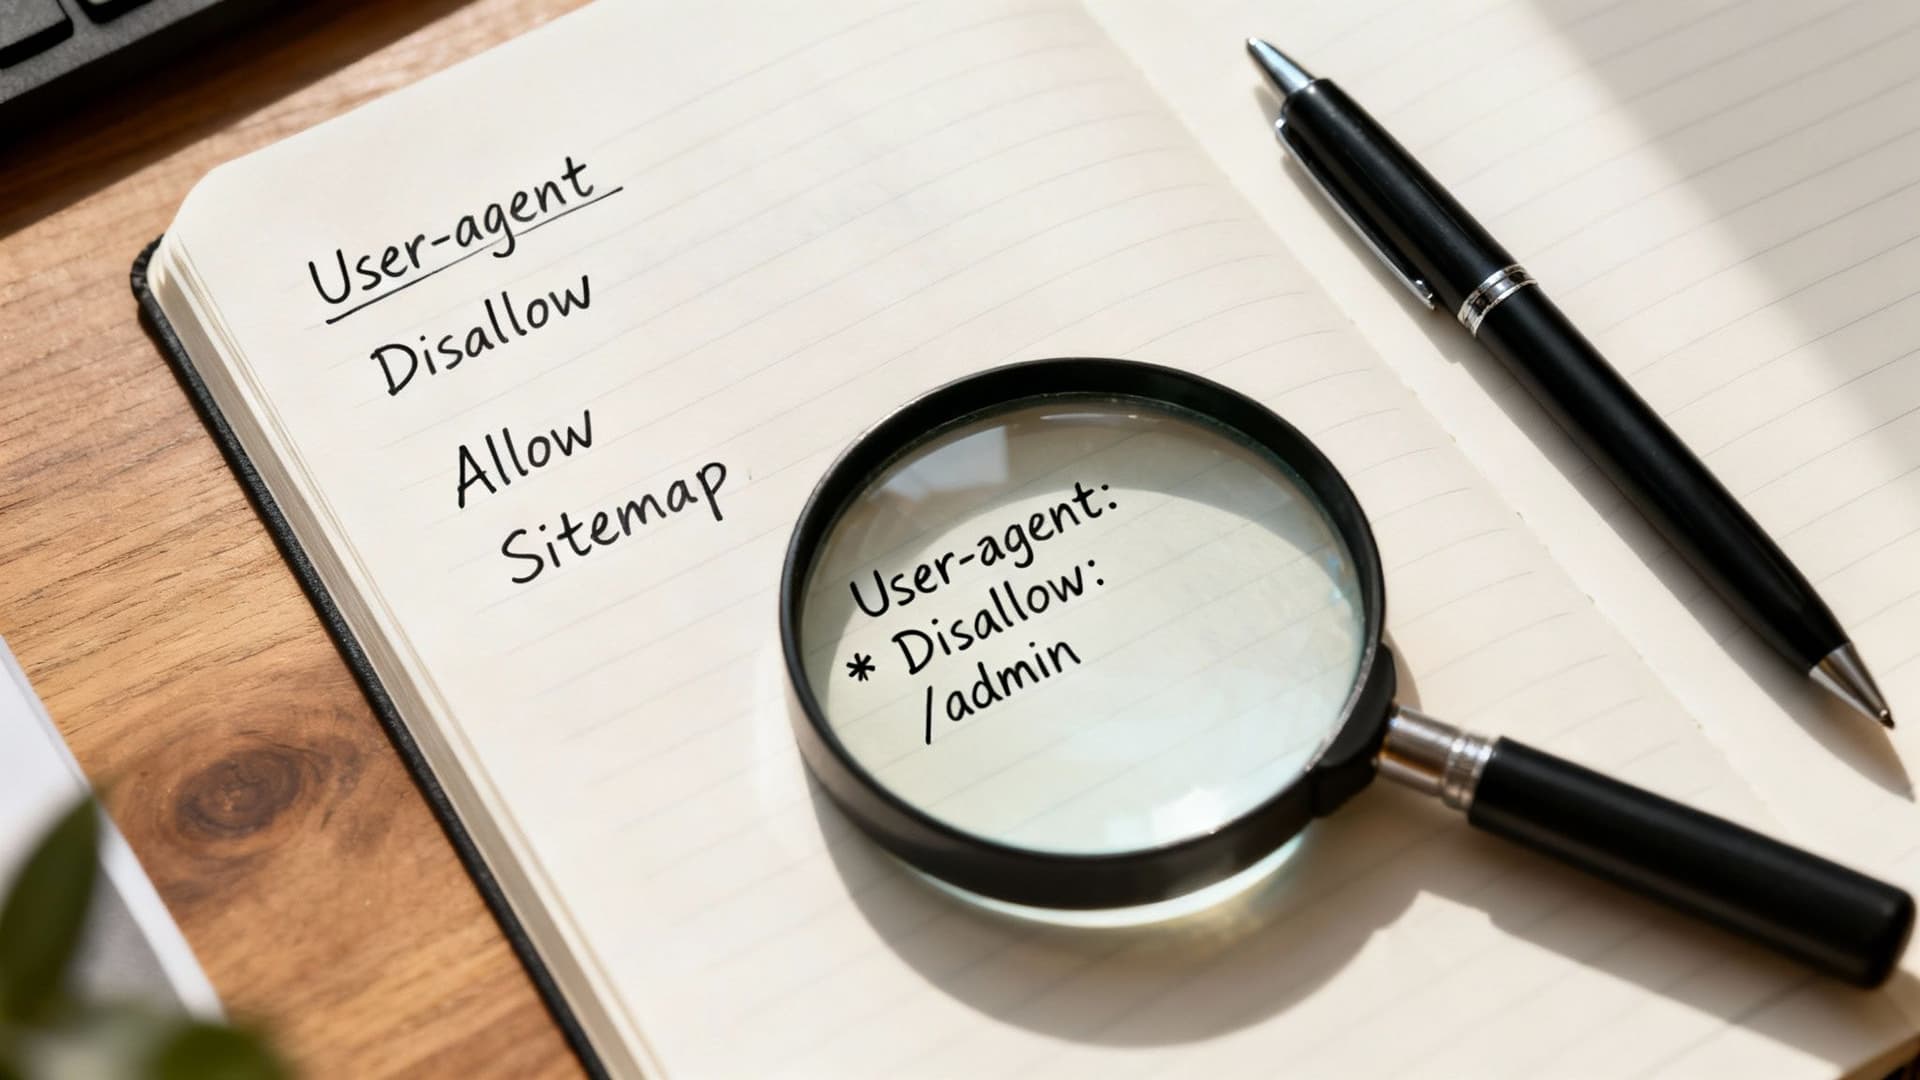
robots.txt はクローラーとの短いやり取りです。シンプルなディレクティブで、どのドアが開いているか閉じているかを示します。これらの基本コマンドを理解することが、健全なテクニカルSEOの基礎となります。
Core robots.txt directives explained
| Directive | What it does | When to use it |
|---|---|---|
| User-agent | Specifies which crawler the rules apply to. * is a wildcard for all bots. | Use User-agent: * for general rules, or specify Googlebot or Bingbot for targeted instructions. |
| Disallow | Tells bots not to crawl a specific file or directory. | Block admin login pages (/wp-admin/), internal search results, or unhelpful thank-you pages. |
| Allow | Overrides a Disallow for a specific subfolder or file. | Allow a single file inside a disallowed directory. |
| Sitemap | Points crawlers to your sitemap XML file so they can discover important pages. | Always include this to speed discovery of pages you want indexed. |
これらのシンプルなコマンドによってクローラーの挙動を強力に制御できます。マスターすれば、効果的な robots.txt を素早く作れます。
Putting directives into practice
重要なインタラクティブツール(例:リード獲得用電卓)はインデックス化したい一方で、管理領域やサンクスページは検索結果に出したくないことがあります。一般的で実用的な robots.txt は次のようになります:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
この設定は全てのボットに対する基本的な対処を示し、一般的な非公開フォルダをブロックし、サイトマップを指し示します。クローラーの挙動を詳しく知るにはサーバーログやアクセス解析を使って、どのボットがどのくらい来ているかを確認してください。ボットトラフィックの割合はサイトごとに異なるため、ログ分析で実態を把握することが重要です2。
A practical guide to creating your robots.txt file manually
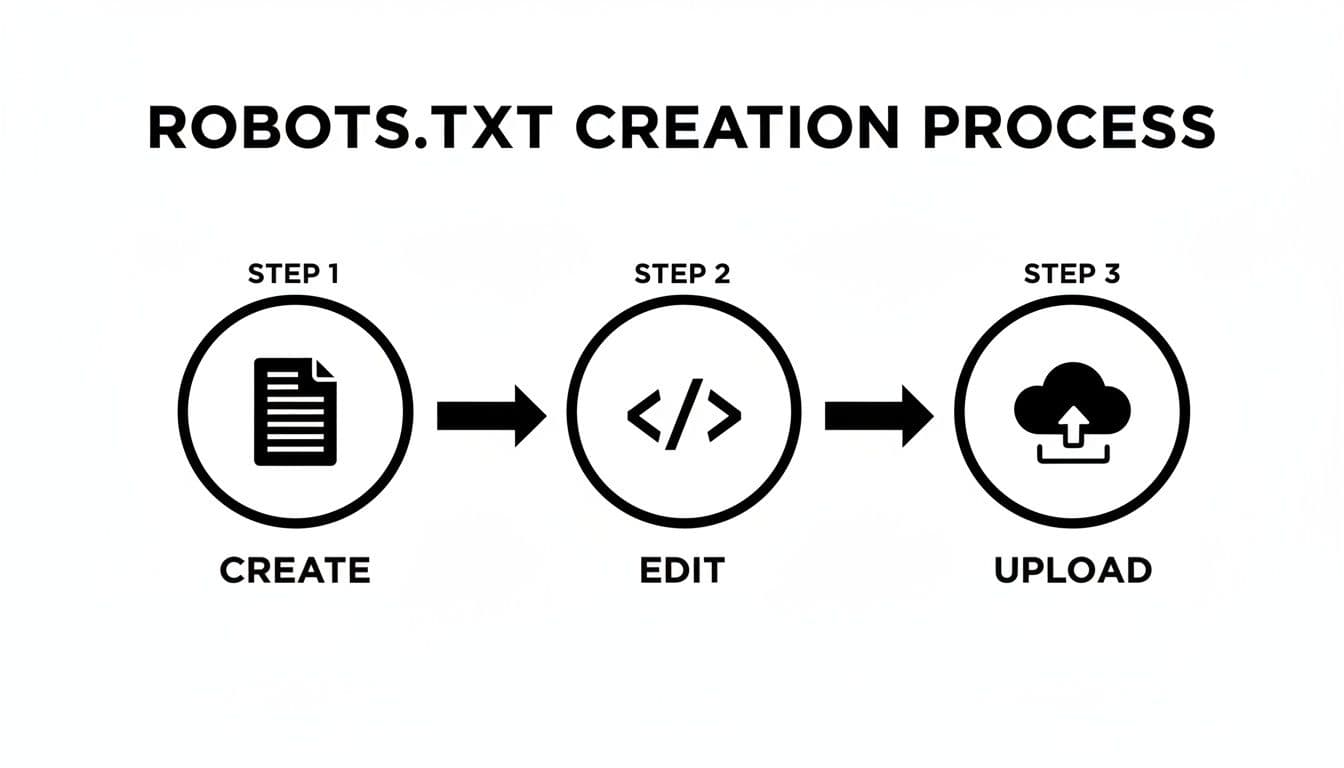
手動でファイルを作成する場合は、Notepad や TextEdit を使い、プレーンテキストとして robots.txt(小文字)という名前で保存し、FTP やホストのファイルマネージャーを介してサイトルートにアップロードしてください。.docx や .rtf として保存すると、クローラーは無視します。
必ず https://yourdomain.com/robots.txt に配置してください。サブフォルダに置くとクローラーからは見えません。
Crafting rules for real-world business goals
例:リード獲得用の住宅ローン計算機を備えた金融サービスサイト。ツールはインデックス化したいが、管理領域やサンクスページは検索結果に出したくない。ルール例:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
この例はサイト全体のクロールを許可しつつ、管理領域とサンクスページだけをブロックします。サイトマップの行を含めることで、クローラーが重要なページを見つけやすくなります。
注:
AllowとDisallowが重複する場合は、より具体的なルールが優先されます。Google の公式ドキュメントで挙動を確認してください3。
robots.txt の作成とテストは、あらゆるテクニカルSEO監査の核心的なステップです。
Managing the new wave of AI and LLM crawlers
近年、GPTBot や Common Crawl のような AI 専用クローラーが増えています。礼儀正しい AI クローラーは robots.txt を遵守しますが、悪意あるスクレイパーは従わないことがあります。多くのサイト運営者が AI クローラーへの対応ルールを見直しています4。
Why you might block AI crawlers
AI クローラーをブロックすることで、オリジナルコンテンツがスクレイピングされモデル訓練に無断で利用されるのを防げます。独自ツールやデータを持つサイトは、可視性の利点と再利用リスクを比較して判断してください。ログファイルの分析はどのボットがサイトを訪れているかを判断するうえで重要です2。
How to block common AI bots
ブロックしたい各クローラーに対して特定の User-agent 行を追加します。例:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
robots.txt は名誉システムである点に注意してください。より強力な対策が必要なら、WAF や専用のボット管理ソリューションを導入してください。
Avoiding common and costly robots.txt mistakes
1 行の誤りでサイト全体が意図せずインデックス解除されることがあります。典型的なミスは Disallow: / で、これは全てのクローラーにどのページもクロールさせないように指示します。サイトが検索結果から突然消えたら、まず robots.txt を確認してください。
Blocking essential files
CSS や JavaScript をブロックすると、Google がページを正しくレンダリングできなくなり、SEO に悪影響を及ぼします。重要なコンテンツの読み込みに JavaScript が必要なサイトでは /assets/js/ をブロックしないでください。必要ならそのリソースに対して Allow: を使います:
- Before (incorrect):
Disallow: /assets/js/ - After (correct):
Allow: /assets/js/
Conflicting rules and syntax errors
ルールは上から下へと読まれます。/private/ をブロックしつつその中の単一ファイルを許可したい場合は、より具体的な Allow を先に置きます:
Allow: /private/public-report.pdf
Disallow: /private/
タイプミスにも注意してください。例えば "dissallow" のような綴り間違いのディレクティブは無視されます。変更をデプロイする前に Google Search Console の robots.txt テスターなどで確認しましょう3。
Common questions about robots.txt files
Robots.txt vs. noindex: what’s the difference?
Robots.txt はクロールを止め、noindex タグはインデックス化を止めます。クロール自体を止めたいセクションには robots.txt を使い、クロールは許可するが検索結果には表示したくないページには noindex を使ってください。
Should I add my sitemap to my robots.txt file?
はい。Sitemap: https://www.yourdomain.com/sitemap.xml を追加すると、クローラーが深いリンクのある価値の高いコンテンツをより早く発見してインデックス化するのに役立ちます。複数のサイトマップがある場合は、それぞれのファイルに Sitemap: 行を追加してください。
Can robots.txt stop bad bots and scrapers?
robots.txt は礼儀正しいクローラーには効果的ですが、悪意あるスクレイパーは無視することが多いです。堅牢な保護には、robots.txt とサーバーレベルの制御、WAF、およびボット管理ツールの組み合わせが必要です。
Ready to boost your site’s engagement and SEO with interactive tools? With MicroEstimates, you can build and embed custom calculators on your site. Try these tools to support lead generation and user engagement:
Quick Q&A — common reader questions
What’s the simplest robots.txt for most sites?
Start with:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
How do I block GPTBot or other AI crawlers?
ブロックしたい各クローラーに対して User-agent ディレクティブを追加し、その下に Disallow: / を設定してください。
How do I test my robots.txt before deploying?
Google Search Console の robots.txt テスターを使用し、サーバーログを確認して期待どおりに動いているか確かめてください3。
追加の簡潔Q&A
robots.txt を変更したらどのくらいで効果が出ますか?
多くの場合、変更は即時に反映されますが、検索エンジンが新しいファイルを再取得するタイミングによって数時間から数日かかることがあります。
サイトマップは robots.txt と別に送信したほうが良いですか?
両方行うと良いです。robots.txt にサイトマップを記載し、Search Console でサイトマップを送信すると発見が早くなります。
robots.txt でブロックしたページは検索結果から必ず消えますか?
必ずしもそうではありません。robots.txt はクロールを防ぎますが、別のサイトからのリンクなどでインデックスに残ることがあります。確実にインデックスから外すには noindex タグを使用してください。
3つの簡潔な追加Q&A(記事の要点まとめ)
Q: robots.txt で最初にチェックするべきことは?
A: Disallow: / のような全体ブロックが入っていないか、重要な CSS/JS を誤ってブロックしていないかを最初に確認してください。
Q: AI クローラーは全てブロックすべきか?
A: コンテンツの性質によります。独自データやツールを保護したい場合は、特定の User-agent をブロックするのが実用的です。
Q: テスト手順の最短ルートは?
A: robots.txt をアップロード後、Google Search Console のテスターで検証し、サーバーログでクロール挙動を数日間モニタリングしてください3。
1.
Robots Exclusion Protocol origin and history. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Reports on automated bot traffic and its share of web traffic. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Analysis and advice on robots.txt and testing from Google Developers. https://developers.google.com/search/docs/advanced/robots/intro
4.
Coverage of publishers blocking AI training bots. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
無料で自分だけのツールを作る準備はできていますか?
すでにカスタム見積もりツールを使用して利益を増やし、より多くの顧客を獲得している数百の企業に参加しましょう
✨ プログラミング不要 • 🚀 数分で準備完了 • 💸 無料で作成