Impara a generare un file robots txt per controllare i crawler e migliorare la SEO tecnica con una guida pratica e operativa.
January 11, 2026 (8mo ago)
Master SEO: genera il file robots txt con questa guida rapida
Impara a generare un file robots txt per controllare i crawler e migliorare la SEO tecnica con una guida pratica e operativa.
← Back to blog
Generare robots.txt: guida rapida alla SEO
Sommario: Impara come creare e distribuire un file robots.txt per controllare i crawler, proteggere i contenuti e ottimizzare il crawl budget con esempi pratici.
Introduzione
Un file robots.txt ben progettato ti dà il controllo su quali crawler possono accedere al tuo sito, aiuta a proteggere contenuti preziosi e concentra il crawl budget sulle pagine che contano. Questa guida mostra passaggi chiari e pratici per creare, testare e aggiornare il tuo robots.txt in modo che i motori di ricerca e i bot educati si comportino come desideri.
Per iniziare
Crea un file di testo semplice chiamato robots.txt, aggiungi direttive come User-agent: e Disallow:, e caricalo nella root del tuo sito su https://yourdomain.com/robots.txt. Quel singolo file funge da semplice insieme di istruzioni per i crawler dei motori di ricerca e altri bot.
Perché il tuo file robots.txt è uno strumento SEO critico
Mettere mano a robots.txt può sembrare tecnico, ma è il guardiano del tuo sito web. Usato correttamente, preserva le risorse del server e indirizza i crawler verso le pagine ad alto valore—migliorando indicizzazione e posizionamento. Il Robots Exclusion Protocol risale ai primi tempi del web, e il suo ruolo si è evoluto fino a diventare un pezzo chiave dell'infrastruttura del sito.1
Un robots.txt mirato ti aiuta a indirizzare i crawler verso le pagine che portano traffico, lead e ricavi, mantenendoli lontani da aree che sprecano crawl budget, come pagine di amministrazione, risultati di ricerca interni e versioni duplicate ottimizzate per la stampa.
Un file robots.txt è più di una lista di esclusione; è una guida strategica per i motori di ricerca. Dice loro dove spendere il loro tempo limitato sul tuo sito, influenzando direttamente quali pagine vengono indicizzate e posizionate.
In definitiva, mettere a punto il robots.txt significa migliori prestazioni SEO, risorse del server preservate e una scoperta più chiara dei tuoi contenuti più preziosi.
Capire il linguaggio dei crawler web
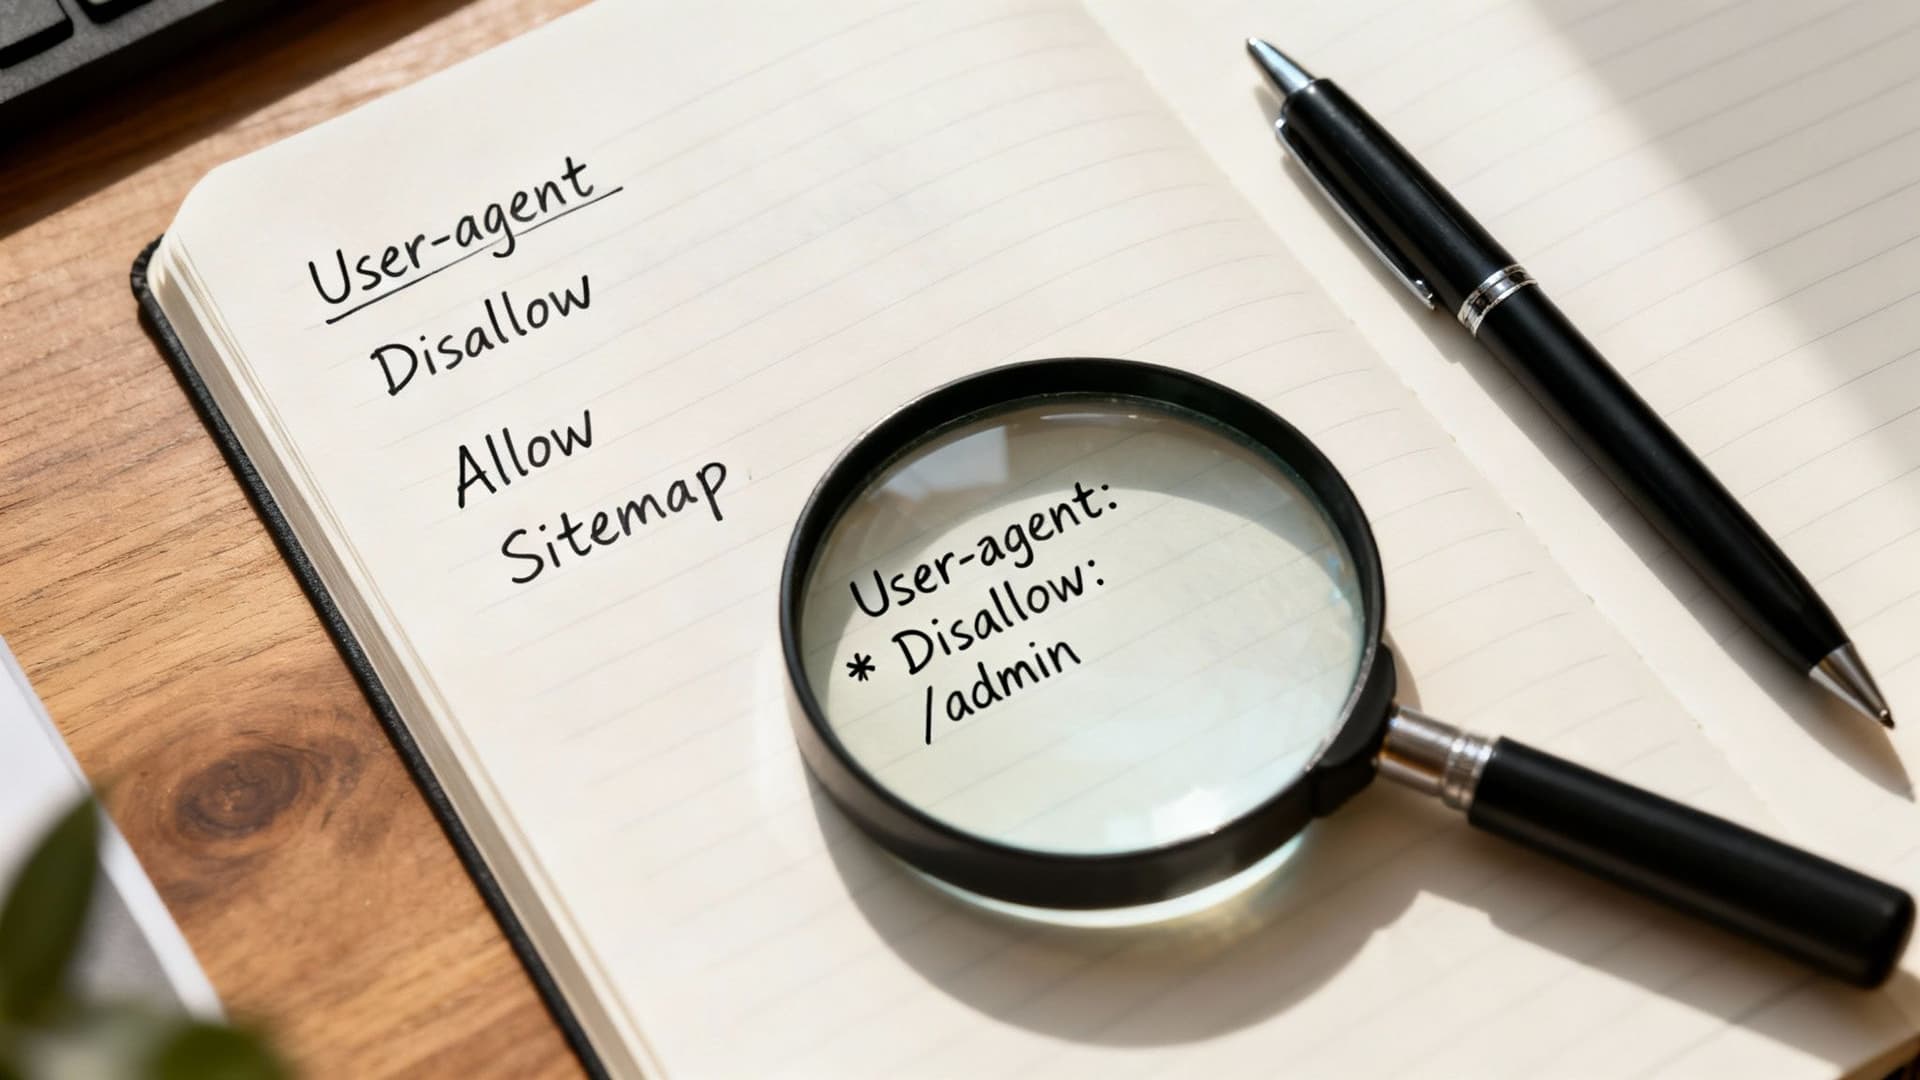
Robots.txt è una breve conversazione con i crawler. Il file usa direttive semplici per indicare quali porte sono aperte o chiuse. Questi comandi sono diretti e formano la base di una sana strategia di SEO tecnica.
Principali direttive robots.txt spiegate
| Direttiva | Cosa fa | Quando usarla |
|---|---|---|
| User-agent | Specifica a quale crawler si applicano le regole. * è un carattere jolly per tutti i bot. | Usa User-agent: * per regole generali, oppure specifica Googlebot o Bingbot per istruzioni mirate. |
| Disallow | Dice ai bot di non effettuare il crawl di un file o di una directory specifica. | Blocca le pagine di login dell'amministrazione (/wp-admin/), i risultati di ricerca interni o pagine di ringraziamento non utili. |
| Allow | Annulla un Disallow per una sottocartella o un file specifico. | Consenti un singolo file all'interno di una directory proibita. |
| Sitemap | Indica ai crawler il tuo file sitemap XML così possono scoprire le pagine importanti. | Includilo sempre per velocizzare la scoperta delle pagine che vuoi indicizzare. |
Questi semplici comandi ti danno un forte controllo sul comportamento dei crawler. Padroneggiarli ti aiuta a creare un file robots.txt efficace.
Mettere in pratica le direttive
Se hai uno strumento interattivo importante—per esempio, un calcolatore che genera lead—vuoi che i motori di ricerca lo esplorino e lo indicizzino. Allo stesso tempo, vorrai bloccare pagine che non aggiungono valore SEO. Un robots.txt comune e pratico assomiglia a questo:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
Questa configurazione usa User-agent: * per rivolgersi a tutti i bot, blocca alcune cartelle non pubbliche comuni e indirizza i crawler alla sitemap. È pulita ed efficiente.
Per saperne di più sul comportamento dei crawler, analizza i log del server e i dati dei visitatori. Una volta capito quali bot stanno visitando il tuo sito, puoi creare regole che supportino i tuoi obiettivi di business.
Guida pratica per creare manualmente il tuo file robots.txt
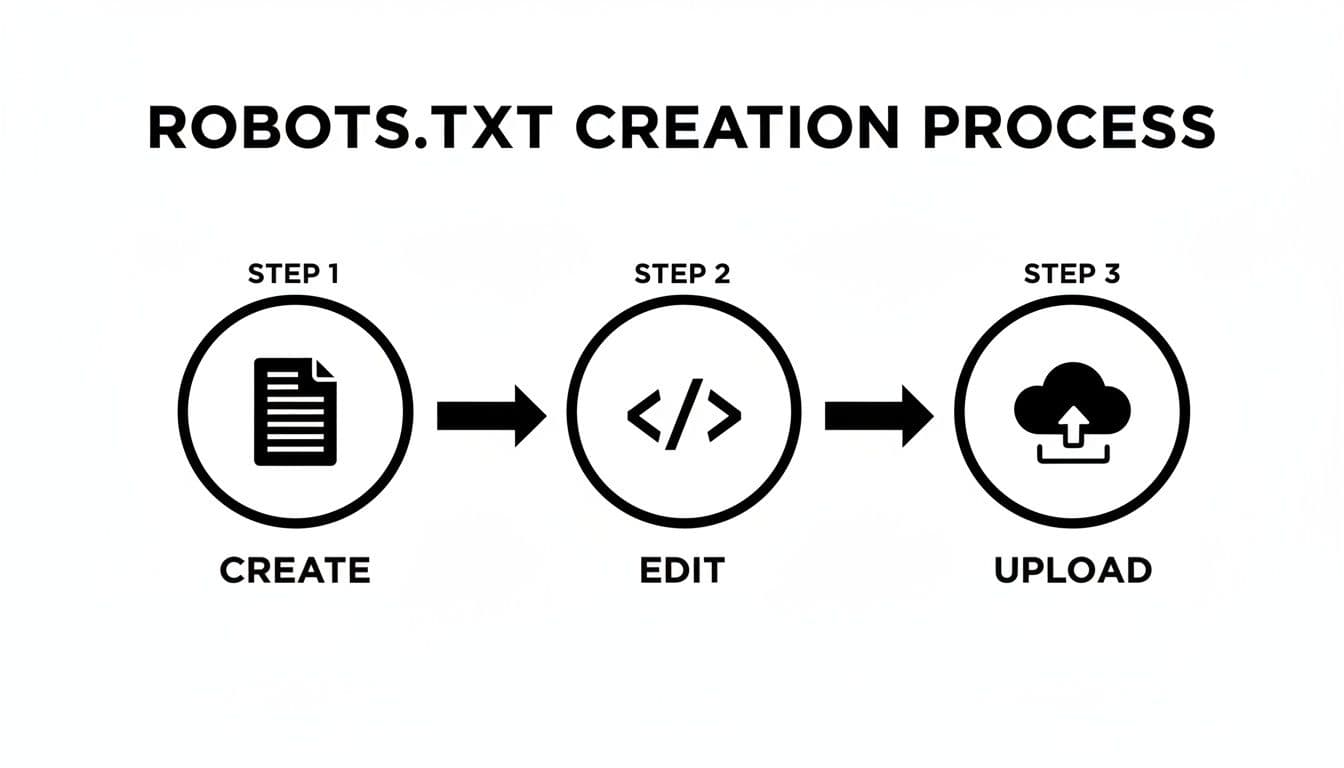
A volte è opportuno creare il file a mano. Usa Notepad o TextEdit, salva il file come testo semplice chiamato robots.txt (minuscolo) e caricalo nella root del sito tramite FTP o il file manager del tuo hosting. Se lo salvi come .docx o .rtf, i crawler lo ignoreranno.
Posizionalo su https://yourdomain.com/robots.txt. Caricarlo in una sottocartella, come /blog/robots.txt, lo rende invisibile ai crawler.
Creare regole per obiettivi aziendali reali
Esempio: un sito di servizi finanziari con un calcolatore di mutui che genera lead. Vuoi che quello strumento sia indicizzato, ma non vuoi aree di amministrazione o pagine di ringraziamento nei risultati di ricerca. Imposta le tue regole così:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
Questo dice a tutti i crawler che possono scansionare il sito tranne /admin/ e la pagina di ringraziamento, e li indirizza a una sitemap. Includi una riga sitemap così per aiutare i crawler a trovare pagine profonde o importanti più rapidamente.
Nota: l'ordine conta in file più complessi. Per regole
AlloweDisallowsovrapposte, la regola più specifica dovrebbe venire prima per Googlebot, altrimenti rischi di bloccare contenuti involontariamente.
Creare e testare il tuo robots.txt è un passaggio fondamentale in ogni audit tecnico SEO.
Gestire la nuova ondata di crawler AI e LLM
Il panorama dei crawler ora include bot specifici per l'AI come GPTBot e Common Crawl. Questi crawler sono cresciuti rapidamente, e molti siti stanno adattando le regole per gestirli. I crawler AI educati rispetteranno robots.txt, ma gli scraper malevoli potrebbero non farlo.2
Perché potresti bloccare i crawler AI
Bloccare i crawler AI può proteggere contenuti originali dallo scraping e dall'utilizzo per l'addestramento di modelli senza attribuzione o compenso. Se hai costruito uno strumento online unico, potresti non voler che la sua logica o i suoi dati vengano raccolti da terzi. Valuta i benefici della visibilità sulle piattaforme guidate dall'AI rispetto al rischio che i tuoi contenuti vengano riutilizzati.
Analizzare i file di log ti aiuta a vedere quali bot visitano il tuo sito e ti informa se è il caso di bloccarli.3
Come bloccare i bot AI comuni
Aggiungi righe User-agent specifiche per ogni crawler che vuoi bloccare. Esempi includono GPTBot, CCBot, Google-Extended e Anthropic-AI. Per bloccare completamente un bot:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Ricorda, robots.txt è un sistema basato sull'onore. I crawler affidabili rispetteranno le tue regole, ma gli attori malevoli potrebbero ignorarle. Per una protezione più robusta, considera un Web Application Firewall (WAF) o una soluzione dedicata di gestione dei bot.
Evitare errori comuni e costosi con robots.txt
Una singola riga fuori posto può inavvertitamente rimuovere l'indicizzazione di tutto il tuo sito. L'errore classico è Disallow: /, che dice a tutti i crawler di non scandagliare nessuna pagina. Se il tuo sito sparisce improvvisamente dai risultati di ricerca, controlla prima robots.txt.
Bloccare file essenziali
Bloccare CSS o JavaScript può impedire a Google di renderizzare correttamente le pagine, il che danneggia la SEO. Per esempio, non bloccare /assets/js/ se il tuo sito si affida a JavaScript per caricare contenuti importanti. Invece usa Allow: per quelle risorse quando necessario:
- Prima (errato):
Disallow: /assets/js/ - Dopo (corretto):
Allow: /assets/js/
Regole confliggenti ed errori di sintassi
Le regole vengono lette dall'alto verso il basso, e le regole più specifiche dovrebbero venire prima di quelle più generiche. Se vuoi bloccare una cartella /private/ ma consentire un singolo PDF al suo interno, metti prima la regola Allow per Googlebot:
Allow: /private/public-report.pdf
Disallow: /private/
Fai anche attenzione agli errori di battitura. Una direttiva scritta male come "dissallow" viene ignorata. Usa il tester di robots.txt di Google Search Console prima di distribuire le modifiche.
Ricorda, robots.txt è una richiesta educata, non una garanzia. Molti grandi editori stanno bloccando i bot di addestramento AI, ma scraper determinati possono ignorare completamente il tuo file.4
Domande comuni sui file robots.txt
Robots.txt vs. noindex: qual è la differenza?
Robots.txt impedisce il crawling, mentre un tag noindex impedisce l'indicizzazione. Usa robots.txt per evitare che i crawler visitino sezioni come le pagine di amministrazione; usa noindex su pagine che vuoi che siano scansionate ma non mostrate nei risultati di ricerca, come landing page temporanee.
Dovrei aggiungere la mia sitemap al file robots.txt?
Sì. Aggiungere Sitemap: https://www.yourdomain.com/sitemap.xml aiuta i crawler a scoprire e indicizzare contenuti profondi e di alto valore più rapidamente. Se usi più sitemap, aggiungi una riga Sitemap: per ciascun file.
Robots.txt può fermare bot malevoli e scraper?
Robots.txt aiuta ma non è infallibile. È efficace contro i crawler ben comportati, ma gli scraper malevoli spesso lo ignorano. Per una protezione robusta, combina robots.txt con controlli a livello di server, un WAF e strumenti di gestione dei bot.
Pronto a aumentare l'engagement e la SEO del tuo sito con strumenti interattivi? Con MicroEstimates puoi creare e incorporare calcolatori personalizzati sul tuo sito. Prova questi strumenti per supportare la generazione di lead e l'engagement degli utenti:
Q&A veloce — domande comuni dei lettori
Qual è il robots.txt più semplice per la maggior parte dei siti?
Inizia con:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
Come blocco GPTBot o altri crawler AI?
Aggiungi una direttiva User-agent per ogni crawler e imposta Disallow: / sotto di essa.
Come testo il mio robots.txt prima di distribuirlo?
Usa il tester di robots.txt di Google Search Console e controlla i log del server per confermare il comportamento che ti aspetti.
1.
Robots Exclusion Protocol origin and history. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Reports on automated bot traffic and its share of web traffic. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Analysis and advice on managing AI crawlers and log-file analysis. https://developers.google.com/search/docs/advanced/robots/intro
4.
Coverage of publishers blocking AI training bots. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
Pronto a costruire i tuoi strumenti gratuitamente?
Unisciti a centinaia di aziende che stanno già utilizzando strumenti di stima personalizzati per aumentare i profitti e conquistare più clienti
✨ Nessuna programmazione richiesta • 🚀 Pronto in minuti • 💸 Gratuito da creare