सीखें कि कैसे एक robots.txt फ़ाइल बनाकर क्रॉलर को नियंत्रित करें और व्यावहारिक, हैंड्स-ऑन गाइड के साथ तकनीकी SEO को बढ़ाएं।
January 11, 2026 (9mo ago)
SEO में महारथ: इस त्वरित मार्गदर्शिका से robots.txt फ़ाइल बनाएं
सीखें कि कैसे एक robots.txt फ़ाइल बनाकर क्रॉलर को नियंत्रित करें और व्यावहारिक, हैंड्स-ऑन गाइड के साथ तकनीकी SEO को बढ़ाएं।
← Back to blog
Generate robots.txt: Quick SEO Guide
Summary: जानें कि कैसे एक robots.txt फ़ाइल बनाकर क्रॉलर को नियंत्रित करें, मूल्यवान सामग्री की सुरक्षा करें, और व्यावहारिक उदाहरणों के साथ क्रॉल बजट को अनुकूलित करें।
Introduction
एक अच्छी तरह से तैयार की गई robots.txt फ़ाइल आपको यह नियंत्रित करने देती है कि कौन से क्रॉलर आपकी साइट तक पहुँच सकते हैं, मूल्यवान सामग्री की सुरक्षा करती है, और क्रॉल बजट को उन पृष्ठों पर केंद्रित करती है जो मायने रखते हैं। यह गाइड दिखाता है कि robots.txt बनाने, परीक्षण करने और अपडेट करने के स्पष्ट, व्यावहारिक कदम कैसे उठाएँ ताकि सर्च इंजन और विनम्र बॉट आपके अनुसार व्यवहार करें।
To get started
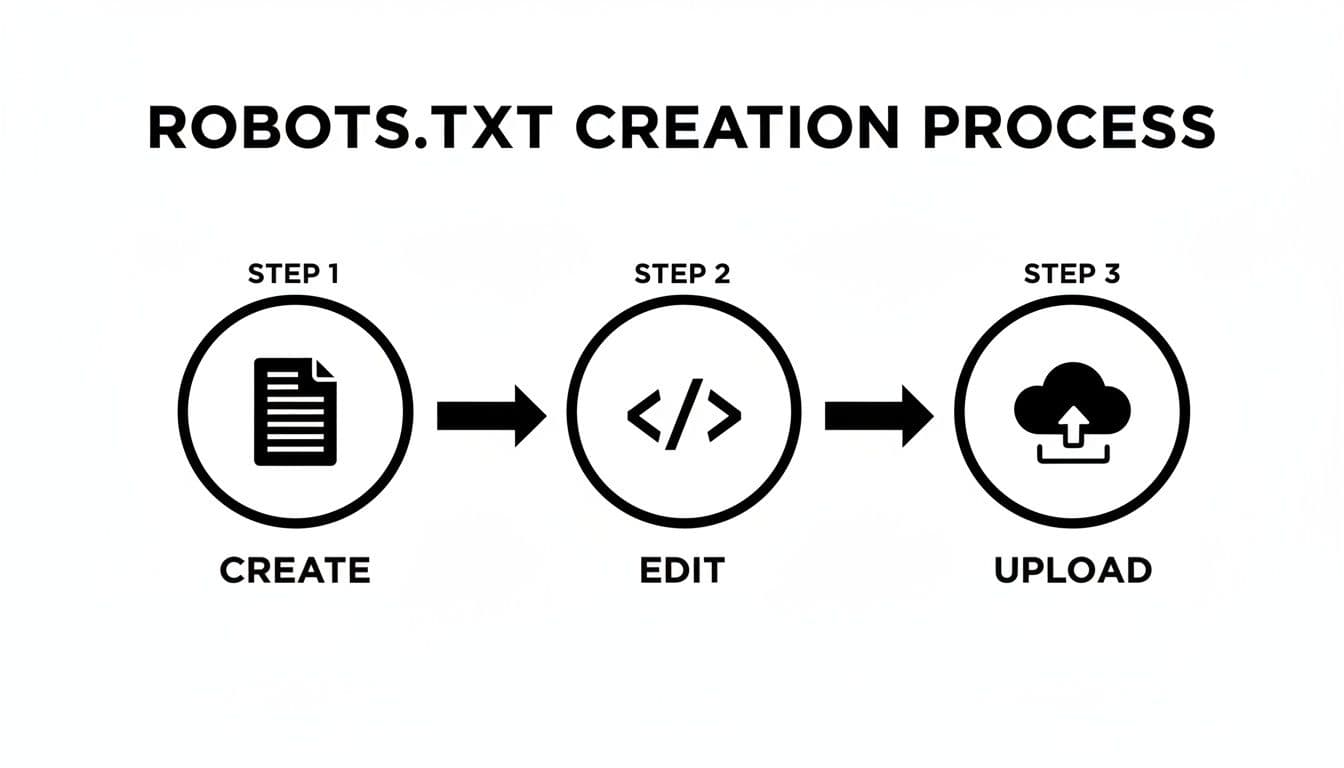
एक सादे पाठ की फ़ाइल बनाएं जिसका नाम robots.txt रखें, User-agent: और Disallow: जैसे निर्देश जोड़ें, और इसे अपनी साइट की रूट पर https://yourdomain.com/robots.txt पर अपलोड करें। वह एकल फ़ाइल सर्च इंजन क्रॉलर और अन्य बॉट्स के लिए एक सरल निर्देश सेट के रूप में काम करती है।
Why your robots.txt file is a critical SEO tool
robots.txt के साथ छेड़छाड़ तकनीकी लग सकती है, लेकिन यह आपकी वेबसाइट का गेटकीपर है। सही ढंग से उपयोग करने पर यह सर्वर संसाधनों की रक्षा करता है और क्रॉलरों को उच्च-मूल्य वाले पृष्ठों की ओर निर्देशित करता है—जिससे इंडेक्सिंग और रैंकिंग में सुधार होता है। Robots Exclusion Protocol वेब के शुरुआती दिनों से मौजूद है, और इसका रोल साइट इंफ्रास्ट्रक्चर के एक प्रमुख हिस्से के रूप में विकसित हुआ है.1
एक केंद्रित robots.txt आपको उन पृष्ठों की ओर क्रॉलर को मोड़ने में मदद करता है जो ट्रैफिक, लीड और राजस्व लाते हैं, जबकि उन्हें उन क्षेत्रों से दूर रखता है जो क्रॉल बजट को बर्बाद करते हैं—जैसे एडमिन पृष्ठ, आंतरिक सर्च परिणाम, और पृष्ठों के डुप्लिकेट प्रिंट-फ्रेंडली संस्करण।
एक robots.txt फ़ाइल केवल एक बहिष्करण सूची से अधिक है; यह सर्च इंजनों के लिए एक रणनीतिक मार्गदर्शिका है। यह उन्हें बताती है कि आपकी साइट पर अपने सीमित समय का उपयोग कहाँ करना है, जो सीधे यह प्रभावित करता है कि किन पृष्ठों का इंडेक्स और रैंक होगा।
अंततः, robots.txt को सही तरीके से सेट करना बेहतर SEO प्रदर्शन, सर्वर संसाधनों की सुरक्षा, और आपकी सबसे मूल्यवान सामग्री की स्पष्ट खोजप्रक्रिया का कारण बनता है।
Understanding the language of web crawlers
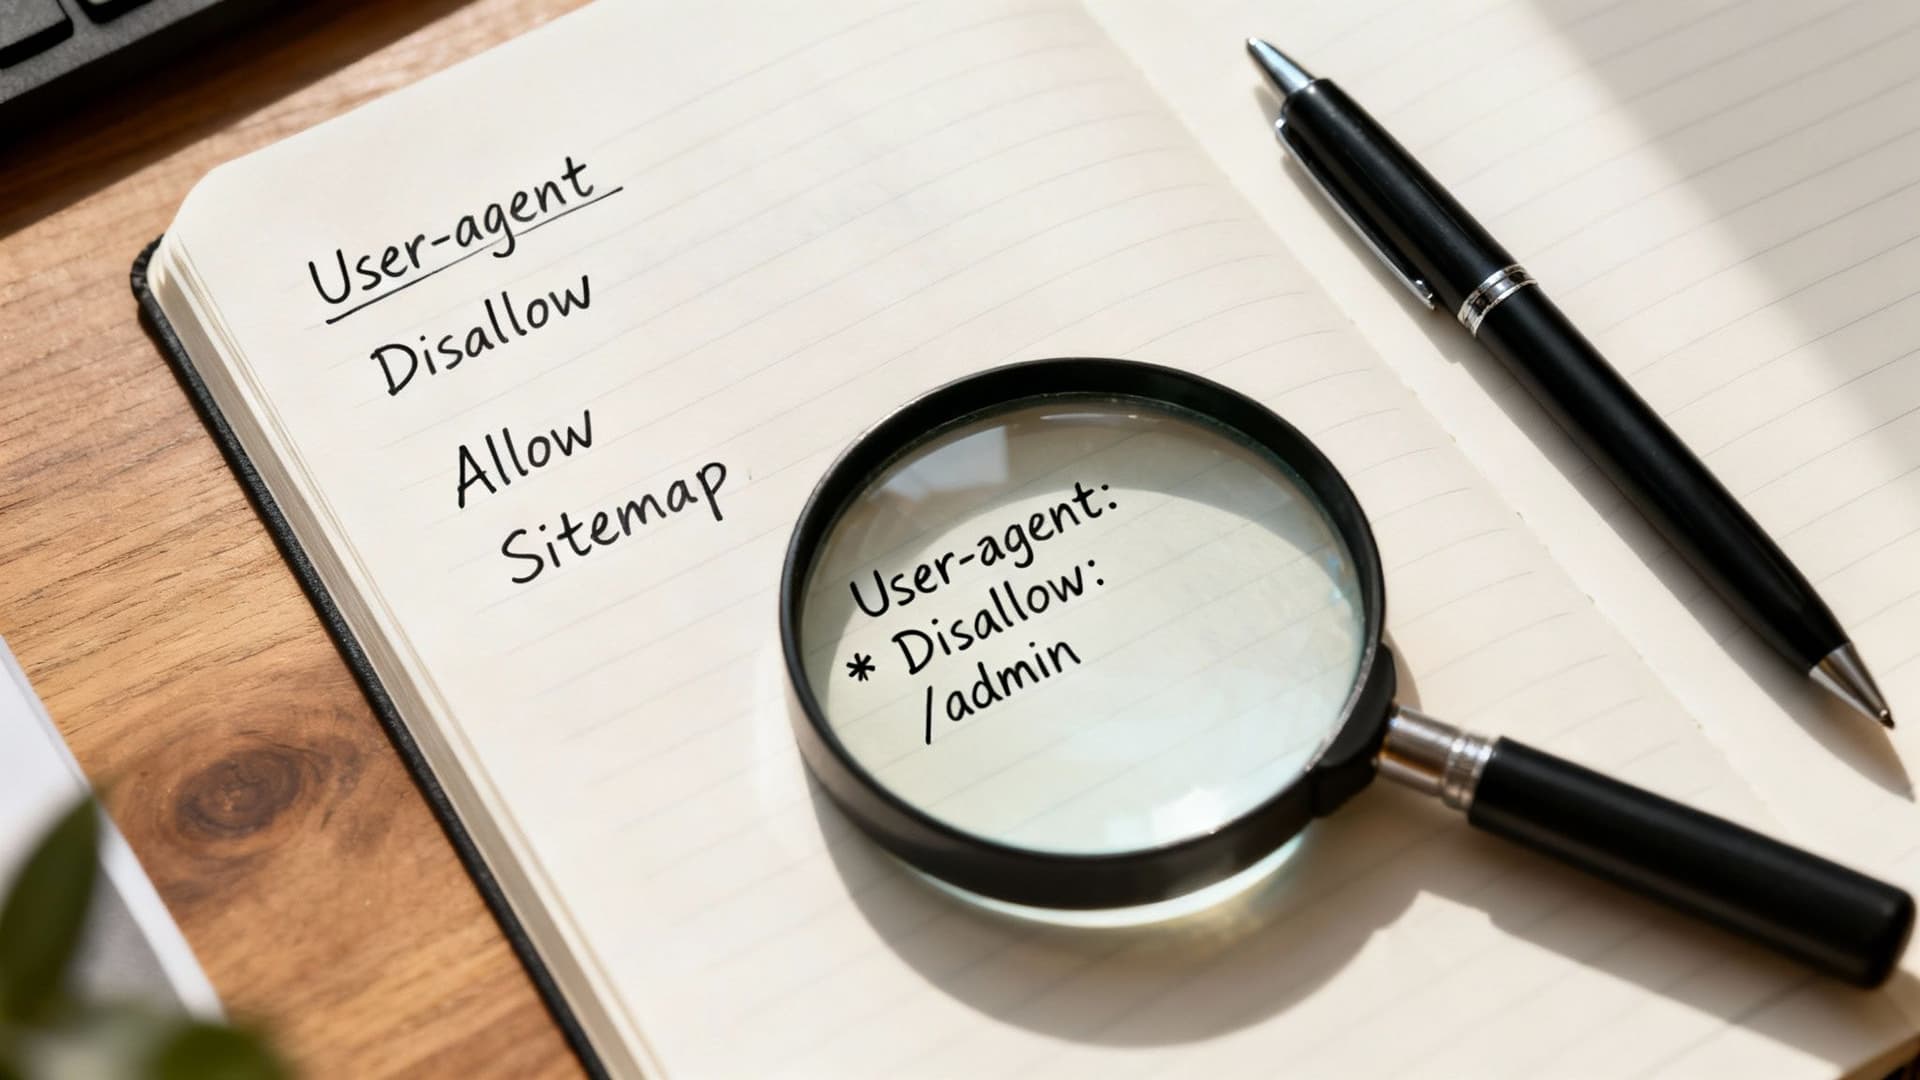
Robots.txt क्रॉलरों के साथ एक छोटा संवाद है। फ़ाइल सरल निर्देशों का उपयोग करती है ताकि संकेत दिया जा सके कि कौन से द्वार खुले हैं या बंद। ये कमांड सीधे-सादे हैं और एक स्वस्थ तकनीकी SEO रणनीति की नींव बनाते हैं।
Core robots.txt directives explained
| Directive | What it does | When to use it |
|---|---|---|
| User-agent | Specifies which crawler the rules apply to. * is a wildcard for all bots. | Use User-agent: * for general rules, or specify Googlebot or Bingbot for targeted instructions. |
| Disallow | Tells bots not to crawl a specific file or directory. | Block admin login pages (/wp-admin/), internal search results, or unhelpful thank-you pages. |
| Allow | Overrides a Disallow for a specific subfolder or file. | Allow a single file inside a disallowed directory. |
| Sitemap | Points crawlers to your sitemap XML file so they can discover important pages. | Always include this to speed discovery of pages you want indexed. |
ये सरल कमांड आपको क्रॉलर व्यवहार पर मजबूत नियंत्रण देती हैं। इन्हें अच्छी तरह समझना एक प्रभावी robots.txt फ़ाइल बनाने में मदद करता है।
Putting directives into practice
यदि आपके पास एक महत्वपूर्ण इंटरैक्टिव टूल है—मान लीजिए, एक लीड-जेनरेटिंग कैलकुलेटर—तो आप चाहेंगे कि सर्च इंजन इसे क्रॉल और इंडेक्स करें। उसी समय, आप उन पृष्ठों को ब्लॉक करना चाहेंगे जो SEO मूल्य नहीं जोड़ते। एक सामान्य, व्यावहारिक robots.txt इस तरह दिखता है:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
यह सेटअप User-agent: * का उपयोग करके सभी बॉट्स को संबोधित करता है, कुछ आम नॉन-पब्लिक फ़ोल्डर्स को ब्लॉक करता है, और क्रॉलरों को साइटमैप की ओर निर्देशित करता है। यह साफ़ और कुशल है।
यह जानने के लिए कि क्रॉलर कैसे व्यवहार करते हैं, सर्वर लॉग और विज़िटर डेटा का विश्लेषण करें। एक बार जब आप समझ जाते हैं कि कौन से बॉट आपकी साइट पर आ रहे हैं, तो आप ऐसे नियम बना सकते हैं जो आपके व्यवसायिक लक्ष्यों का समर्थन करें।
A practical guide to creating your robots.txt file manually
कभी-कभी आपको फ़ाइल को हाथ से बनाना चाहिए। Notepad या TextEdit का उपयोग करें, फ़ाइल को सादा टेक्स्ट के रूप में robots.txt (लोअरकेस) नाम से सेव करें, और इसे FTP या अपने होस्ट के फ़ाइल मैनेजर के माध्यम से साइट रूट पर अपलोड करें। यदि आप इसे .docx या .rtf के रूप में सेव करते हैं, तो क्रॉलर इसे अनदेखा करेंगे।
इसे https://yourdomain.com/robots.txt पर रखें। इसे किसी सबफ़ोल्डर में अपलोड करना, जैसे /blog/robots.txt, क्रॉलरों के लिए इसे अदृश्य बना देता है।
Crafting rules for real-world business goals
उदाहरण: एक वित्तीय सेवाओं वाली साइट जिसमें एक लीड-जेनरेटिंग Mortgage Calculator है। आप चाहते हैं कि वह टूल इंडेक्स हो, लेकिन आप नहीं चाहते कि एडमिन क्षेत्र या थैंक-यू पेज सर्च परिणामों में दिखें। अपने नियम इस तरह सेट करें:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
यह सभी क्रॉलरों को बताता है कि वे साइट को क्रॉल कर सकते हैं सिवाय /admin/ और थैंक-यू पेज के, और उन्हें साइटमैप की ओर इशारा करता है। इस तरह का एक sitemap लाइन शामिल करना क्रॉलरों को गहरे या महत्वपूर्ण पेजों को तेज़ी से खोजने में मदद करता है।
नोट: अधिक जटिल फ़ाइलों में क्रम महत्वपूर्ण होता है। ओवरलैपिंग
AllowऔरDisallowनियमों के लिए, सबसे विशिष्ट नियम Googlebot के लिए पहले आना चाहिए, अन्यथा आप अनजाने में सामग्री को ब्लॉक कर सकते हैं।
अपनी robots.txt बनाना और परीक्षण करना किसी भी तकनीकी SEO ऑडिट का एक मुख्य कदम है।
Managing the new wave of AI and LLM crawlers
अब के क्रॉलर परिदृश्य में GPTBot और Common Crawl जैसे AI-विशिष्ट बॉट्स शामिल हैं। ये क्रॉलर तेजी से बढ़े हैं, और कई साइटें इन्हें संबोधित करने के लिए नियम समायोजित कर रही हैं। विनम्र AI क्रॉलर robots.txt का सम्मान करेंगे, लेकिन दुर्भावनापूर्ण स्क्रैपर्स ऐसा नहीं कर सकते।2
Why you might block AI crawlers
AI क्रॉलर को ब्लॉक करने से मूल सामग्री को स्क्रैपिंग और मॉडल प्रशिक्षण के लिए बिना श्रेय या मुआवजा के उपयोग किए जाने से बचाया जा सकता है। यदि आपने एक अनोखा ऑनलाइन टूल बनाया है, तो आप नहीं चाहेंगे कि तीसरे पक्ष द्वारा उसकी लॉजिक या डेटा को संग्रहित किया जाए। AI-ड्राइवेन प्लेटफ़ॉर्म पर दिखाई देने के फ़ायदे बनाम आपकी सामग्री के पुन: उपयोग के जोखिम को तौलें।
लॉग फ़ाइलों का विश्लेषण आपको दिखाता है कि कौन से बॉट आपकी साइट पर आते हैं और यह निर्णय लेने में मदद करता है कि उन्हें ब्लॉक करना चाहिए या नहीं।3
How to block common AI bots
उन प्रत्येक क्रॉलर के लिए विशिष्ट User-agent लाइनों को जोड़ें जिन्हें आप ब्लॉक करना चाहते हैं। उदाहरणों में GPTBot, CCBot, Google-Extended, और Anthropic-AI शामिल हैं। किसी बॉट को पूरी तरह ब्लॉक करने के लिए:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
याद रखें, robots.txt एक सम्मान प्रणाली है। प्रतिष्ठित क्रॉलर आपके नियमों का सम्मान करेंगे, लेकिन दुर्भावनापूर्ण एक्टर्स उन्हें अनदेखा कर सकते हैं। मजबूत सुरक्षा के लिए, एक Web Application Firewall (WAF) या समर्पित बोट मैनेजमेंट समाधान पर विचार करें।
Avoiding common and costly robots.txt mistakes
एक गलत जगह पर लगी एक लाइन आपकी पूरी साइट को अनजाने में डी-इंडेक्स कर सकती है। क्लासिक त्रुटि है Disallow: /, जो सभी क्रॉलरों को किसी भी पेज को क्रॉल न करने का कहता है। यदि आपकी साइट अचानक सर्च रिज़ल्ट से गायब हो जाए, तो पहले robots.txt की जाँच करें।
Blocking essential files
CSS या JavaScript को ब्लॉक करने से Google पृष्ठों को सही तरीके से रेंडर नहीं कर पाएगा, जिससे SEO को नुकसान होता है। उदाहरण के लिए, यदि आपकी साइट महत्वपूर्ण सामग्री लोड करने के लिए JavaScript पर निर्भर है, तो /assets/js/ को ब्लॉक न करें। इसके बजाय उन संसाधनों के लिए आवश्यकता होने पर Allow: का उपयोग करें:
- Before (incorrect):
Disallow: /assets/js/ - After (correct):
Allow: /assets/js/
Conflicting rules and syntax errors
नियम ऊपर से नीचे पढ़े जाते हैं, और अधिक विशिष्ट नियमों को व्यापक नियमों से पहले रखा जाना चाहिए। यदि आप /private/ फ़ोल्डर को ब्लॉक करना चाहते हैं लेकिन उसके अंदर एक एकल PDF की अनुमति देना चाहते हैं, तो Googlebot के लिए Allow नियम पहले रखें:
Allow: /private/public-report.pdf
Disallow: /private/
टाइपो पर भी ध्यान दें। "dissallow" जैसे गलत लिखे निर्देश को अनदेखा कर दिया जाता है। परिवर्तन लागू करने से पहले Google Search Console के robots.txt Tester का उपयोग करें।
याद रखें, robots.txt एक शिष्ट अनुरोध है, गारंटी नहीं। कई बड़े प्रकाशक AI ट्रेनिंग बॉट्स को ब्लॉक कर रहे हैं, लेकिन दृढनिश्चयी स्क्रैपर्स आपकी फ़ाइल को पूरी तरह अनदेखा कर सकते हैं।4
Common questions about robots.txt files
Robots.txt vs. noindex: what’s the difference?
Robots.txt क्रॉलिंग को रोकता है, जबकि noindex टैग इंडेक्सिंग को रोकता है। robots.txt का उपयोग उन सेक्शनों को रोकने के लिए करें जिन्हें आप चाहते हैं कि क्रॉलर विज़िट न करें, जैसे एडमिन पेज; noindex का उपयोग उन पृष्ठों पर करें जिन्हें आप क्रॉल कराना चाहते हैं लेकिन सर्च रिज़ल्ट में नहीं दिखाना चाहते—जैसे अस्थायी लैंडिंग पृष्ठ।
Should I add my sitemap to my robots.txt file?
हाँ। Sitemap: https://www.yourdomain.com/sitemap.xml जोड़ने से क्रॉलर को गहरे-लिंक किए गए, उच्च-मूल्य वाले कंटेंट को तेज़ी से खोजने और इंडेक्स करने में मदद मिलती है। यदि आप कई साइटमैप का उपयोग करते हैं, तो प्रत्येक फ़ाइल के लिए एक Sitemap: लाइन जोड़ें।
Can robots.txt stop bad bots and scrapers?
Robots.txt मदद करता है लेकिन यह पूरी तरह से दोषरहित नहीं है। यह अच्छे व्यवहार वाले क्रॉलर के खिलाफ प्रभावी है, लेकिन दुर्भावनापूर्ण स्क्रैपर्स अक्सर इसे अनदेखा कर देते हैं। मजबूत सुरक्षा के लिए robots.txt को सर्वर-स्तर नियंत्रण, WAF, और बोट मैनेजमेंट टूल्स के साथ संयोजित करें।
Ready to boost your site’s engagement and SEO with interactive tools? With MicroEstimates, you can build and embed custom calculators on your site. Try these tools to support lead generation and user engagement:
Quick Q&A — common reader questions
What’s the simplest robots.txt for most sites?
Start with:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
How do I block GPTBot or other AI crawlers?
Add a User-agent directive for each crawler and set Disallow: / beneath it.
How do I test my robots.txt before deploying?
Use Google Search Console’s robots.txt Tester and check server logs to confirm the behavior you expect.
1.
Robots Exclusion Protocol origin and history. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Reports on automated bot traffic and its share of web traffic. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Analysis and advice on managing AI crawlers and log-file analysis. https://developers.google.com/search/docs/advanced/robots/intro
4.
Coverage of publishers blocking AI training bots. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
क्या आप अपना खुद का उपकरण मुफ्त में बनाने के लिए तैयार हैं?
सैकड़ों व्यापारों से जुड़ें जो पहले से ही मुनाफा बढ़ाने और अधिक ग्राहक जीतने के लिए कस्टम अनुमान उपकरणों का उपयोग कर रहे हैं
✨ कोडिंग की आवश्यकता नहीं • 🚀 मिनटों में तैयार • 💸 बनाना मुफ्त