Eine sorgfältig gestaltete robots.txt-Datei gibt Ihnen Kontrolle darüber, welche Crawler Ihre Seite besuchen, schützt sensible Bereiche und fokussiert das Crawl-Budget auf die Seiten, die wirklich zählen.
January 11, 2026 (9mo ago) — last updated October 7, 2026 (16d ago)
robots.txt: Schnellleitfaden für technisches SEO
Erstellen, testen und optimieren Sie Ihre robots.txt, um Crawler zu steuern, Crawl-Budget zu sparen und technisches SEO schnell zu verbessern.
← Back to blog
Generate robots.txt: Quick SEO Guide
Zusammenfassung: Erfahren Sie, wie Sie eine robots.txt-Datei erstellen und bereitstellen, um Crawler zu steuern, Inhalte zu schützen und das Crawl-Budget mit praktischen Beispielen zu optimieren.
Einleitung
Eine sorgfältig gestaltete robots.txt-Datei gibt Ihnen Kontrolle darüber, welche Crawler auf Ihre Seite zugreifen dürfen, schützt sensible Bereiche und fokussiert das Crawl-Budget auf die Seiten, die wirklich zählen. Dieser Leitfaden zeigt klare, praxisnahe Schritte zum Erstellen, Testen und Aktualisieren Ihrer robots.txt, damit Suchmaschinen und höfliche Bots sich so verhalten, wie Sie es möchten.
Zum Einstieg
Erstellen Sie eine Textdatei mit dem Namen robots.txt, fügen Sie Direktiven wie User-agent: und Disallow: hinzu und laden Sie sie ins Stammverzeichnis Ihrer Seite unter https://yourdomain.com/robots.txt hoch. Diese einzelne Datei fungiert als einfache Anweisungssammlung für Suchmaschinen-Crawler und andere Bots.
Warum Ihre robots.txt-Datei ein kritisches SEO-Tool ist
Arbeit mit robots.txt mag technisch wirken, aber sie ist der Türsteher Ihrer Website. Richtig eingesetzt, spart sie Serverressourcen und lenkt Crawler zu hochwertigen Seiten, was Indexierung und Rankings verbessern kann. Das Robots Exclusion Protocol hat historische Wurzeln und bleibt Teil einer soliden Website-Infrastruktur1.
Eine fokussierte robots.txt hilft, Crawler zu den Seiten zu lenken, die Traffic, Leads und Umsatz bringen, und sie fernzuhalten von Bereichen, die das Crawl-Budget vergeuden, wie Admin-Seiten, interne Suchergebnisse und doppelte Druckversionen.
Eine robots.txt-Datei ist mehr als eine Ausschlussliste; sie ist ein strategischer Leitfaden für Suchmaschinen. Sie sagt ihnen, wo sie ihre begrenzte Zeit auf Ihrer Seite verbringen sollen, und beeinflusst damit direkt, welche Seiten indexiert und gerankt werden.
Letztendlich bedeutet eine korrekte robots.txt besseres SEO, geschonte Serverressourcen und eine klarere Auffindbarkeit Ihrer wertvollsten Inhalte.
Die Sprache der Web-Crawler verstehen
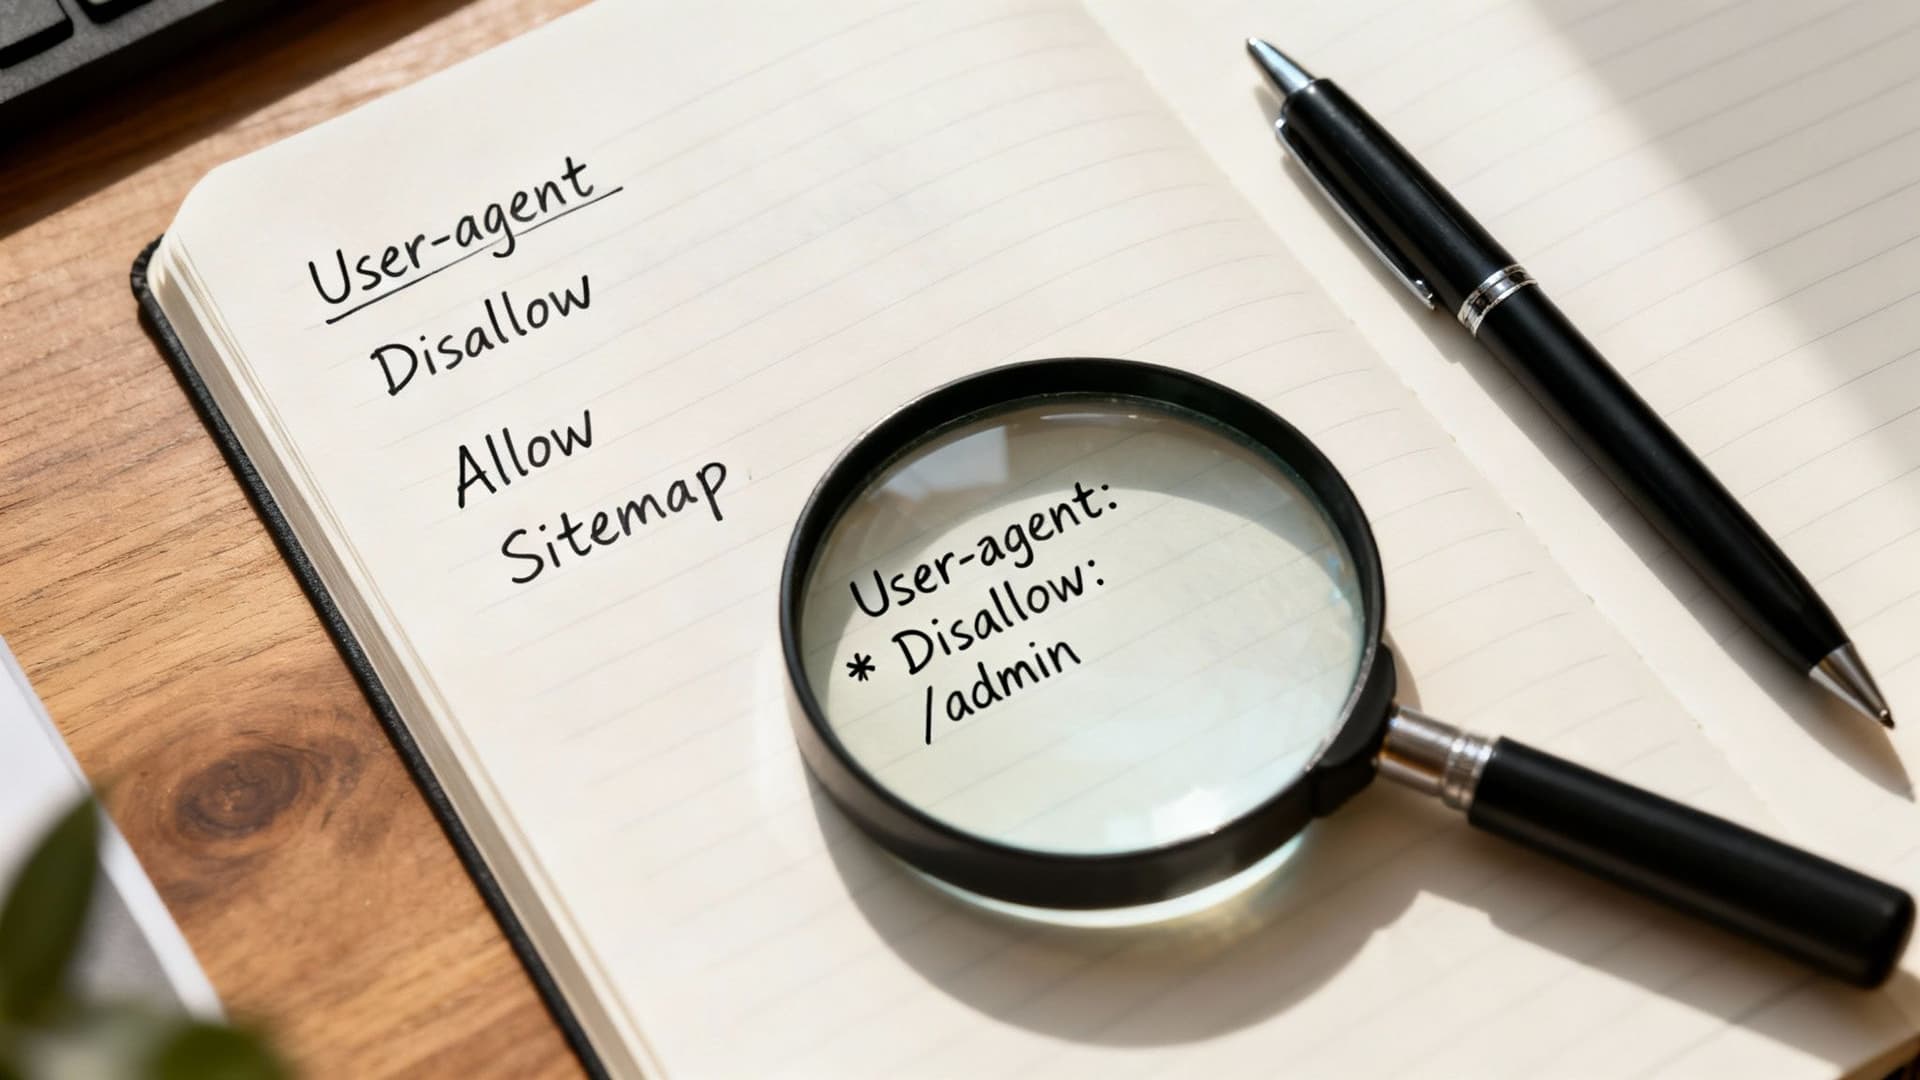
Robots.txt ist ein kurzes Gespräch mit Crawlern. Die Datei verwendet einfache Direktiven, um anzuzeigen, welche Türen offen oder geschlossen sind. Diese Befehle sind leicht verständlich und bilden die Grundlage einer soliden technischen-SEO-Strategie.
Wichtige robots.txt-Direktiven erklärt
| Direktive | Bedeutung | Wann verwenden |
|---|---|---|
| User-agent | Gibt an, für welchen Crawler die Regeln gelten. * ist ein Platzhalter für alle Bots. | User-agent: * für allgemeine Regeln; spezifizieren Sie Googlebot oder Bingbot für gezielte Anweisungen. |
| Disallow | Verhindert, dass Bots ein bestimmtes Verzeichnis oder eine Datei crawlen. | Blockieren Sie Admin-Logins (/wp-admin/), interne Suchergebnisse oder Danke-Seiten. |
| Allow | Hebt ein Disallow für eine bestimmte Datei oder Unterordner auf. | Erlauben Sie einzelne Dateien innerhalb eines blockierten Ordners. |
| Sitemap | Verweist Crawler auf Ihre Sitemap-XML, damit wichtige Seiten schneller gefunden werden. | Immer aufnehmen, um die Entdeckung gewünschter Seiten zu beschleunigen. |
Diese einfachen Befehle geben Ihnen starke Kontrolle über das Verhalten von Crawlern. Sie zu beherrschen hilft beim Erstellen einer effektiven robots.txt-Datei.
Direktiven in der Praxis anwenden
Wenn Sie beispielsweise ein interaktives Tool haben — etwa einen Lead-Generator — möchten Sie, dass Suchmaschinen es crawlen und indexieren. Gleichzeitig sollten Sie Seiten blockieren, die keinen SEO-Wert bringen. Eine gängige robots.txt-Konfiguration sieht so aus:
User-agent: *
Disallow: /wp-admin/
Disallow: /private-files/
Disallow: /cgi-bin/
Sitemap: https://yourdomain.com/sitemap.xml
Diese Datei spricht alle Bots an, blockiert nicht-öffentliche Ordner und verweist auf die Sitemap. Analysieren Sie Server-Logs, um zu verstehen, welche Bots Ihre Seite besuchen, und passen Sie Regeln an, damit sie Ihre Geschäftsziele unterstützen.2
Praktische Anleitung: robots.txt-Datei manuell erstellen
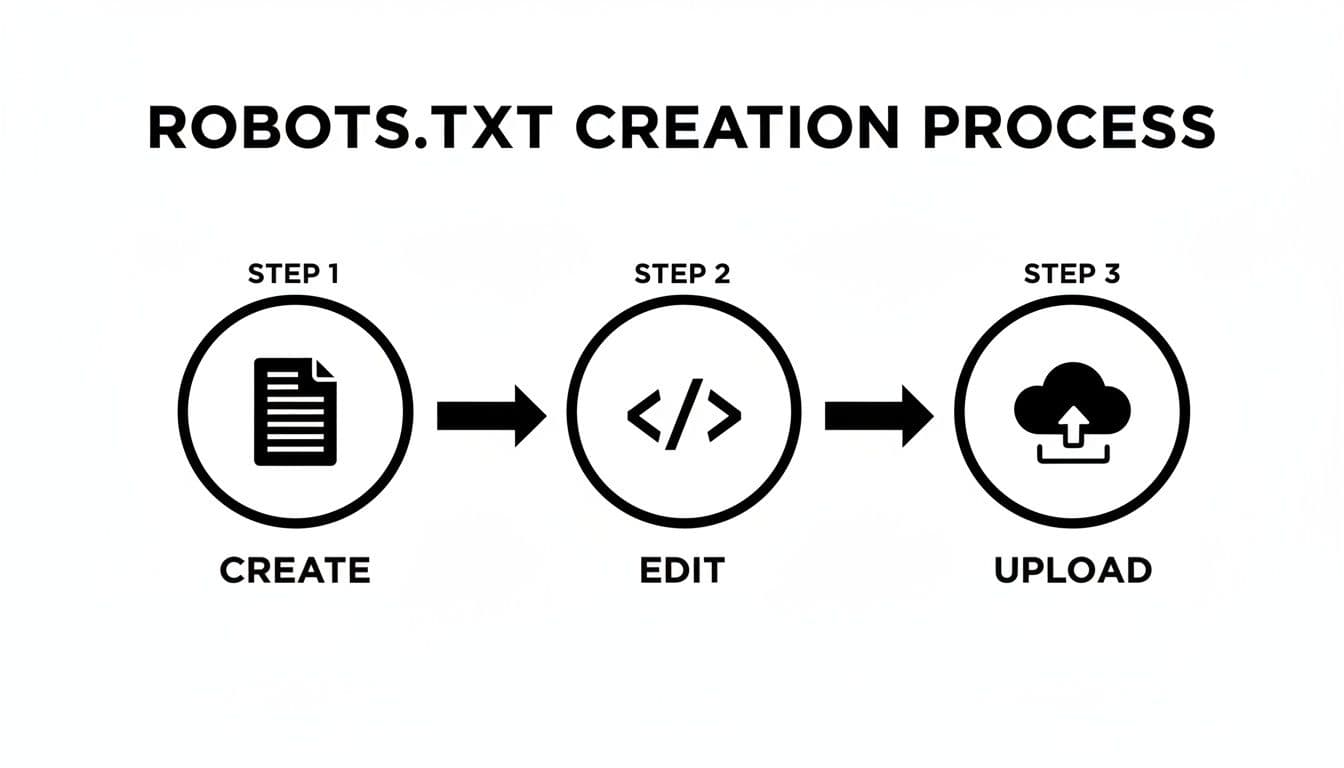
Erstellen Sie die Datei mit Notepad oder TextEdit, speichern Sie sie als reinen Text mit dem Namen robots.txt (kleingeschrieben) und laden Sie sie per FTP oder über den Datei-Manager Ihres Hosts ins Website-Root hoch. Vermeiden Sie .docx oder .rtf, weil Crawler diese Formate ignorieren.
Platzieren Sie die Datei genau unter https://yourdomain.com/robots.txt. Wenn Sie sie in einen Unterordner wie /blog/robots.txt legen, ist sie für Crawler nicht sichtbar.
Regeln für reale Geschäftsziele formulieren
Beispiel für eine Finanzdienstleister-Seite mit einem Hypothekenrechner: Sie möchten, dass das Tool indexiert wird, aber Admin- und Danke-Seiten nicht. Konfiguration:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /thank-you-for-your-submission/

Sitemap: https://www.yourfinancialsite.com/sitemap.xml
Damit erlauben Sie allen Crawlern das Crawlen, schließen /admin/ und die Danke-Seite aus und verweisen auf die Sitemap. Achten Sie auf die Reihenfolge bei sich überschneidenden Regeln; die spezifischste Regel sollte Vorrang haben.
Das Erstellen und Testen Ihrer robots.txt ist ein zentraler Schritt jedes technischen-SEO-Audits.
Umgang mit KI- und LLM-Crawlern
Die Crawler-Landschaft umfasst mittlerweile KI-spezifische Bots wie GPTBot und Common Crawl. Viele Websites passen ihre Regeln an, um auf diese Crawler zu reagieren. Höfliche KI-Crawler halten sich an robots.txt, aber bösartige Scraper oft nicht. Studien zeigen, dass automatisierter Traffic einen erheblichen Anteil am Web-Verkehr ausmacht, was Einfluss auf Serverlast und Datenschutzfragen hat2.
Warum Sie KI-Crawler blockieren könnten
Das Blockieren von KI-Crawlern kann originelle Inhalte davor schützen, zum Modelltraining ohne Zuschreibung oder Vergütung verwendet zu werden. Wenn Sie ein einzigartiges Online-Tool entwickelt haben, möchten Sie möglicherweise nicht, dass dessen Logik oder Daten erfasst werden. Wiegen Sie die Sichtbarkeitsvorteile gegen das Risiko ab, dass Inhalte wiederverwendet werden.
Analysieren Sie Log-Dateien, um zu sehen, welche Bots Ihre Seite besuchen, und entscheiden Sie auf dieser Basis, ob Sie KI-Crawler blockieren wollen3.
Wie man gängige KI-Bots blockiert
Fügen Sie spezifische User-agent-Zeilen für jeden Crawler hinzu, den Sie blockieren möchten. Beispiele:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Robots.txt ist ein Ehrensystem. Seriöse Crawler respektieren Ihre Regeln, böswillige Akteure können sie jedoch ignorieren. Für stärkeren Schutz kombinieren Sie robots.txt mit einer Web Application Firewall (WAF) oder Bot-Management-Lösungen.
Häufige und kostspielige robots.txt-Fehler vermeiden
Eine falsch platzierte Zeile kann Ihre gesamte Seite unbeabsichtigt de-indexieren. Der klassische Fehler ist Disallow: /, was allen Crawlern das Crawlen verbietet. Wenn Ihre Seiten aus den Suchergebnissen verschwinden, prüfen Sie zuerst die robots.txt.
Essentielle Dateien nicht blockieren
Das Blockieren von CSS oder JavaScript kann verhindern, dass Google Seiten korrekt rendert, was dem SEO schadet. Blockieren Sie nicht /assets/js/, wenn Ihre Seite auf JavaScript angewiesen ist. Nutzen Sie stattdessen gezielte Allow:-Regeln für notwendige Ressourcen:
- Vorher (falsch):
Disallow: /assets/js/ - Nachher (richtig):
Allow: /assets/js/
Konfliktierende Regeln und Syntaxfehler
Regeln werden von oben nach unten gelesen; spezifischere Regeln sollten vor allgemeineren stehen. Wenn Sie einen /private/-Ordner blockieren, aber eine einzelne PDF erlauben möchten, setzen Sie die Allow-Regel zuerst für Googlebot:
Allow: /private/public-report.pdf
Disallow: /private/
Achten Sie auf Tippfehler. Eine falsch geschriebene Direktive wie dissallow wird ignoriert. Verwenden Sie das robots.txt-Tester-Tool der Google Search Console, bevor Sie Änderungen live schalten3.
Denken Sie daran: robots.txt ist eine höfliche Aufforderung, keine Garantie. Viele Publisher blockieren KI-Trainings-Bots, aber entschlossene Scraper können die Regeln ignorieren4.
Häufige Fragen zu robots.txt-Dateien
Robots.txt vs. noindex: Was ist der Unterschied?
Robots.txt verhindert das Crawlen; ein noindex-Tag verhindert die Indexierung. Verwenden Sie robots.txt, um Bereiche wie Admin-Seiten vom Crawlen auszuschließen; verwenden Sie noindex, wenn eine Seite gecrawlt werden darf, aber nicht in Suchergebnissen erscheinen soll.
Sollte ich meine Sitemap in die robots.txt-Datei aufnehmen?
Ja. Sitemap: https://yourdomain.com/sitemap.xml hilft Crawlern, tief verlinkte, wertvolle Inhalte schneller zu entdecken. Bei mehreren Sitemaps fügen Sie für jede Datei eine Sitemap:-Zeile hinzu.
Kann robots.txt bösartige Bots und Scraper stoppen?
Robots.txt hilft gegen wohlverhaltende Crawler, ist aber nicht narrensicher. Für robusten Schutz kombinieren Sie robots.txt mit serverseitigen Kontrollen, einer WAF und Bot-Management-Tools.
Bereit, das Engagement und SEO Ihrer Seite mit interaktiven Tools zu steigern? Mit MicroEstimates können Sie benutzerdefinierte Rechner erstellen und in Ihre Seite einbetten. Probieren Sie diese Tools aus, um Lead-Generierung und Nutzerengagement zu unterstützen:
Kurzes Q&A — häufige Leserfragen
Was ist die einfachste robots.txt für die meisten Sites?
Beginnen Sie mit:
User-agent: *
Disallow: /wp-admin/
Sitemap: https://yourdomain.com/sitemap.xml
Wie blockiere ich GPTBot oder andere KI-Crawler?
Fügen Sie für jeden Crawler eine User-agent-Direktive hinzu und setzen Sie darunter Disallow: /.
Wie teste ich meine robots.txt vor der Bereitstellung?
Verwenden Sie den robots.txt-Tester der Google Search Console und prüfen Sie Server-Logs, um das erwartete Verhalten zu bestätigen3.
Kurze, prägnante Q&A — schnelle Antworten
Q: Sollte ich Disallow: / jemals verwenden?
A: Nur wenn Sie die gesamte Website vor Crawling schützen möchten; ansonsten vermeiden — es de-indexiert Seiten vollständig.
Q: Blockiert robots.txt die Indexierung?
A: Nein; robots.txt verhindert Crawlen. Für No-Index verwenden Sie das noindex-Tag.
Q: Wie finde ich, welche Bots meine Seite besuchen?
A: Analysieren Sie Server-Logs und verwenden Sie Bot-Reporting-Tools, um Besuche und Verhalten zu prüfen2.
1.
Robots Exclusion Protocol origin and history. https://en.wikipedia.org/wiki/Robots_exclusion_standard
2.
Reports on automated bot traffic and its share of web traffic. https://www.imperva.com/learn/bot-management/bot-traffic/
3.
Analysis and advice on managing robots.txt and testing. https://developers.google.com/search/docs/advanced/robots/intro
4.
Coverage of publishers blocking AI training bots. https://www.searchenginejournal.com/most-major-news-publishers-block-ai-training-retrieval-bots/564605/
Bereit, Ihre Eigenen Tools kostenlos zu erstellen?
Schließen Sie sich Hunderten von Unternehmen an, die bereits benutzerdefinierte Schätztools verwenden, um Gewinne zu steigern und mehr Kunden zu gewinnen
✨ Keine Programmierung erforderlich • 🚀 In Minuten bereit • 💸 Kostenlos zu erstellen